如何提高自动字幕准确率(减少错误)
如何提高自动字幕准确率:先清干净输入音频、按转写能跟上的方式录制、给人名术语建词表,再用紧凑的校对闭环收尾
作者:Recapo.ai 编辑团队 · 事实核查:2026 年 7 月 10 日
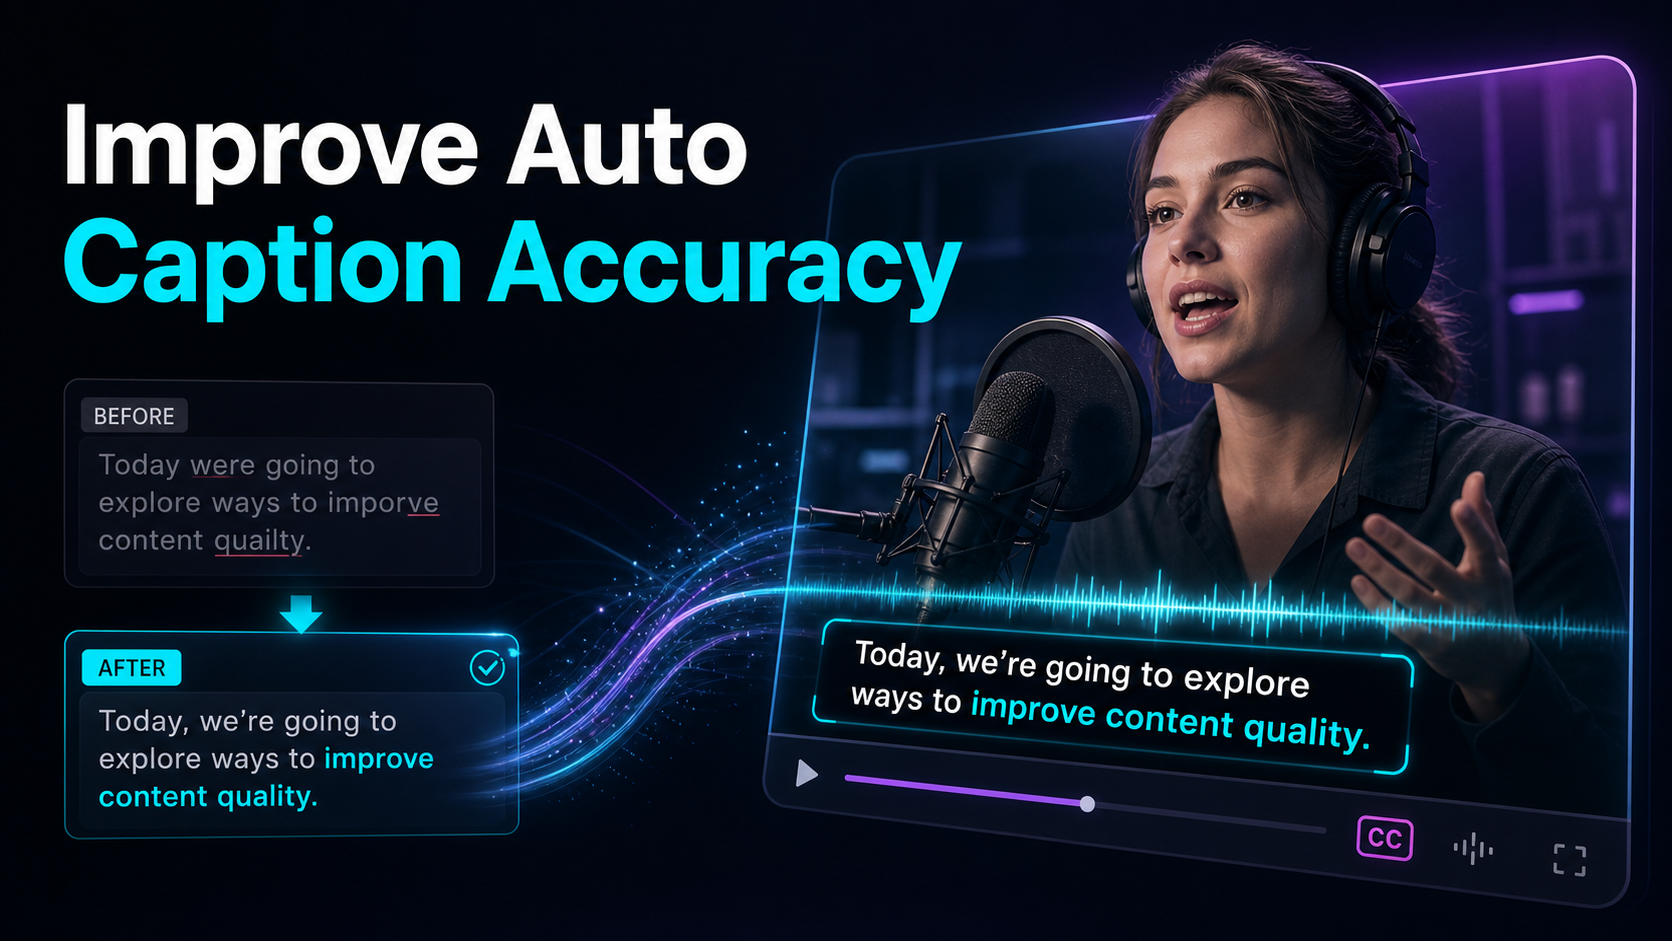
自动字幕会把人名认错、乱打标点、整句听岔——而在"如何提高自动字幕准确率"这件事上,最大的进步往往不来自换工具,而来自修好你喂给工具的东西。语音转文字的上限,就是它听到的音频、以及它预期会出现的那些词,所以本文只紧扣创作者真正能控制的几个杠杆:更干净的输入音频、转写能跟上的录制与说话习惯、给人名和术语准备的一份自定义词表,以及一个能兜住漏网之鱼的、快速的"转写—编辑—导出"闭环。把这四件事做好,字幕不准就不再是反复发作的头疼,而变成一遍很快的校对。
自动字幕为什么会不准——以及如何提高自动字幕准确率
在修好自动字幕之前,先弄清它为什么会错,会很有帮助。每一个自动字幕功能背后都是语音识别:模型听你的音频,猜出最可能的词,再给它们打上时间戳。它出错的方式是可预测的——而这些失误绝大多数都能追回到输入,而不是算法本身。
| 出错原因 | 你能控制吗? | 修法 |
|---|---|---|
| 人声底下压着背景音乐或噪声 | 能 | 转写前先把音频清干净 |
| 两个人抢着说、话音重叠 | 能 | 让每一段只留一个说话人 |
| 房间回声 / 混响 | 大体能 | 录得更近、处理一下房间 |
| 人名、品牌、术语、缩写 | 能 | 喂一份自定义词表,再校对 |
| 语速快、含糊、吞音 | 能 | 放慢、咬字清、麦克风靠近 |
| 口音重或非母语口音 | 部分能 | 挑一个能扛住它的转写工具 |
| 低码率或手机外放采集的音频 | 能 | 录到一个干净的源文件里 |
把这一列"能"读一遍,策略就自己浮现了。别人录的素材里,口音或快嘴你不一定改得动,但你几乎总能给转写工具递上更干净的音频,和一份它大概率会栽跟头的词的清单。杠杆就在这儿——这也是为什么在修好输入之前就去追一个"更聪明"的工具,通常会让人失望。
先修输入:为字幕清干净音频
清理源音频是值得测试的一项改动,因为转写工具只能处理它接收到的信号。两个问题最要命。
稳定的背景噪声——空调嗡嗡、车流、笔记本风扇、底噪嘶声——压在你的人声之下,把词的边缘糊掉,于是模型只能猜。在转写之前把音轨过一遍音频降噪,能把这层底噪压下去,递给模型一个更干净的信号。这一步要在源音频上做、而不是在加完字幕之后——目的是改善转写工具听到的东西,而不是给输出打补丁。
人声底下的音乐床更阴。音乐和语音抢同一片频率空间,所以一个转写工具在一段带垫乐的口播上加字幕时,会把它在干声上本能认对的词漏掉、听岔。如果你的录音把人声和音乐混进了一条轨里,先用人声分离把人声抽出来,从干净的人声去转写,再在最终混音时把音乐加回来。你给字幕转的是人声,不是那首和它较劲的曲子。
噪声或音乐遮挡人声时,可以先测试清理再转写。用音频降噪工具处理代表性样本,与原版的转写错误比较;过度处理也可能损害可理解度。
按转写能跟上的方式录制
准确率有一半,在你还没点"生成"之前、就在录制那一刻定下了。转写工具不会读心,它跟的是你给它的最清晰的那个信号,而下面这些习惯不花一分钱。
- 麦近、电平稳。 声源离说话人近、电平稳定,模型拿到的就是清脆的辅音——大多数词错都藏在那儿——而不是一片带房间味的、发飘的糊音。
- 一次只一个说话人。 抢话是自动字幕垮得最快的地方。两个声音一叠,模型没法干净地归给任何一方,于是两边都糊。做访谈时,提醒嘉宾等一拍再接话。
- 压住房间。 混响会把词尾抹糊。在软装多的空间里录,或者在偏亮的房间里录得离麦更近,都能削掉模型不得不去硬扛的那份回声。
- 以正常人的语速咬清字。 你不需要播音腔——只要避开那种含糊、吞音、赶着说的表达,就是那种连人都会请你再说一遍的。遇到重要的词(人名、数字),把它咬干净落地。
给人名和术语建一份自定义词表
这是多数创作者会跳过的一步,却是能干掉最让你难堪的那类错误的一步。语音识别偏向常见词。给它"Recapo"、一个客户的姓、一个产品货号、或一个圈内缩写,它会去够最近的那个日常词——这正是专有名词和术语成为不准字幕重灾区的原因。
修法有两种形态:
- 一份自定义词典,如果你的工具支持。 有些转写工具允许你在跑任务前登记词条——人名、品牌、专业词汇——好让模型预期它们出现。有这个选项时,它就是把名字一次转对的最干净办法。把你频道天天挂在嘴边的词加进去:自己的品牌、常来的嘉宾、你所在细分领域的行话。
- 一份可复用的更正清单,如果不支持。 没有自定义词典这个字段?就存一个短短的文本文件,记下你的转写工具总念错的那些词、以及它们本该是什么样。每条视频在校对时更正一次,而且因为你是从一份现成清单里粘贴,这一遍是几秒钟的事、而不是大海捞针。
无论哪种,原则都一样:日常口语转写工具自己就能搞定;你的活儿是把那一小撮它猜不出来的生僻词递给它。就这一个习惯,能把大多数"它怎么老拼错我名字"的抱怨,变成一个已解决的问题。
挑一个匹配你音频的转写工具
不是每个语音转文字引擎都能同样地扛住每一种音频——口音、话音重叠、专业词汇、以及非英语语种,都会把工具分出高下。但别信营销文案里那个"准确率"百分比;它是在一段和你完全不像的干净录音棚音频上测出来的。自己测。
拿你最糟的那 60 秒——那个带口音的嘉宾、那个嘈杂的场地、那段术语密集的部分——把它过一遍你正在掂量的每一个转写工具。然后按真正要紧的东西给输出打分:
- 专有名词。 人名、品牌、地名它认对了,还是编了一堆同音词?
- 标点与大小写。 句子断得合不合理,还是糊成一整块流水账?
- 可编辑性。 你能就地改转写——理想的话,在视频旁边改——而不是导出再重新导入?
- 逐词时间。 它是按词打时间戳、而不只是按行——这是你做出贴合、同步良好的字幕所需要的数据。
- 你真正用的语种。 如果你用不止一种语言加字幕,它在每一种上都扛得住吗?
在你真实音频上过关的工具才会顶用;只在样片上出彩的不会。一个能产出可编辑、逐词打时间的转写的通用AI字幕生成器,会给你留下最大的改错余地。想看更广的选项、以及怎么横向比较,见我们整理的最佳自动字幕生成器。
校对闭环:最后那批错误在这里被清掉
就算音频干净、词表也备好了,没有哪一遍自动字幕是原封不动就能发的——而短视频字幕会被烧进画面里,一个错字就成了永久的。一个紧凑的校对闭环,正是"大差不差"和"真的对了"之间那道关。
- 生成转写。 把清理过的音频过一遍自动字幕,拿到带逐词时间轴的定时字幕——这是你要去改的可编辑草稿,而不是终稿。
- 先扫高风险词。 你不用逐词重读;你只盯转写工具最常漏的那四样:人名、同音词("的/得/地"、"在/再")、数字(价格、日期、数据)和术语。把这些修好,你就抓住了真正会折损可信度的那批错误。
- 在视频旁边改。 在一个把片子和文字并排播放的转写视图里更正,好让你在上下文里改掉听岔的地方、并确认时间没有飘。这比闭着眼改一个原始字幕文件快得多。
- 静音读一遍。 把视频静音播放、只读字幕,就像你有些观众那样看——有些短视频观看发生在关闭声音的环境中,平台自家的无障碍指南也这么说。任何静音下读着不对的地方,现在就修。
- 烧录并导出。 只有在转写干净之后,才把字幕渲染进画面帧。因为烧录是永久的,校对从来不是你为省时间而跳过的那一步。
这个闭环生来就短:你的输入和词表越干净,这里要改的就越少。
字幕准确率速查清单
把这份清单放在手边——它是通往更好的自动字幕最短的一条路。大多数准确率问题,只要你在点"生成"之前顺一遍,就消失了。
- 先清音频——降噪,并把任何音乐床分出去,好让你转写的是一段干声。
- 录得近、电平稳、一次一个人声——尽量少抢话、少混响。
- 喂一份自定义词表——品牌、人名、术语、缩写——并在你最糟的片段上测工具,而不是在干净样片上。
- 校对高风险词——人名、同音词、数字、术语——并在烧录前静音读一遍,因为烧进去的错误是永久的。
Recapo 适合放在哪儿
Recapo 是一个浏览器端的 AI 视频工作台——无需安装——本文里这整条准确率闭环,恰好从头到尾都能在它里面跑。你可以降低背景噪声、把音乐床从人声里分出来、转写并加字幕、拿到一份逐词的可编辑转写、在视频旁边校对人名和数字,再改成 9:16、把字幕烧录进去导出——全在一个标签页里,不用在降噪器、转写工具和编辑器之间来回搬文件。它接受 MP4、MOV 及其他常见格式,每个任务合计最多 6GB。
说句实在话:Recapo 负责把输入清干净、给你一份可编辑的转写去改,但它编不出一个它从没听过的名字,也不会替你决定你指的是哪个同音词。那些判断——自定义词表、静音通读、最终校对——仍然归你,正是它们把一遍不错的自动字幕变成一遍干净字幕。如果加字幕是你日常里反复出现的一环,把清音频、转写、校对放进一个标签页,正是它为之而造的事。套餐详情见定价页。
常见问题
我的自动字幕为什么这么不准?
几乎总是因为音频,而不是工具。背景噪声、人声底下的音乐床、话音重叠、以及含糊或发飘的表达,都逼着语音模型去猜,而它在难词上会猜错。人名、品牌和术语又加了一层,因为识别偏向常见词。把音频清干净、录得更近且一次只一个人声、再把生僻词喂给转写工具——这套组合,在你还没开始校对之前,就修掉了大多数不准的字幕。
清理音频真的能提高字幕准确率吗?
通常有帮助,但改善幅度取决于原始噪声、说话清晰度与转写模型,应使用同一片段前后比较。转写工具只能给它听得清的东西加字幕,所以稳定的噪声和一条抢戏的音乐轨,会直接导致词被漏掉、听岔。在转写之前把源音频降噪、并把人声从任何音乐床里分出来,等于递给模型一个更干净的信号,从根上削减错误——远比事后修输出有效。
自动字幕里的人名和术语怎么修?
两条路。如果你的转写工具支持自定义词典,就在跑任务前把人名、品牌和专业词登记进去,好让模型预期它们。如果不支持,就备一份短短的、可复用的清单,记下它总念错的词,在校对时把更正粘上去。两种做法,都能把最让你难堪的那类错误——自己的品牌或嘉宾的名字被拼错——变成一个已解决、可复用的修法。
不重录能提高准确率吗?
很多时候能。你可以给现有音轨降噪、把音乐床从人声里分出来、把清理过的音频过一遍能扛住你这类口音的转写工具,再校对结果——全程不用再录任何东西。只有当源头本身就是问题时(严重抢话、重混响、或手机外放采集),重录才划算;对大多数素材,清输入加校对就能把差距补上。
自动字幕能达到多高的准确率?
它变数太大,没法承诺一个数字——干净、近讲麦、单说话人的音频,转写得远比嘈杂的多人录音好,而且结果因语言和口音而异。与其信厂商的头条百分比,不如拿任何工具在你自己最糟的 60 秒上测一测、看输出。无论用哪个工具,都要给人名、同音词和数字留一遍简短校对,再把字幕烧进去,因为正是这最后一遍让它们能发布。
准备好不再和不准的字幕较劲了吗?免费注册账号,上传你的素材——MP4 或 MOV,每个任务合计最多 6GB——把整条准确率闭环在一个浏览器标签页里跑完:降噪、分出任何音乐床、转写成逐词可编辑的转写、在视频旁边校对人名和数字,再改成 9:16、把字幕烧录进去导出。干净的音频和最后那遍通读由你来带;制作交给 Recapo,好让你的下一条视频带着"你到底说了什么"的字幕发布。