Jak poprawić dokładność autopodpisów (mniej błędów)
Jak poprawić dokładność autonapisów: wyczyść dźwięk wejściowy, nagrać, aby transkrypcy mogli śledzić, wprowadź niestandardową listę słów dla imion.
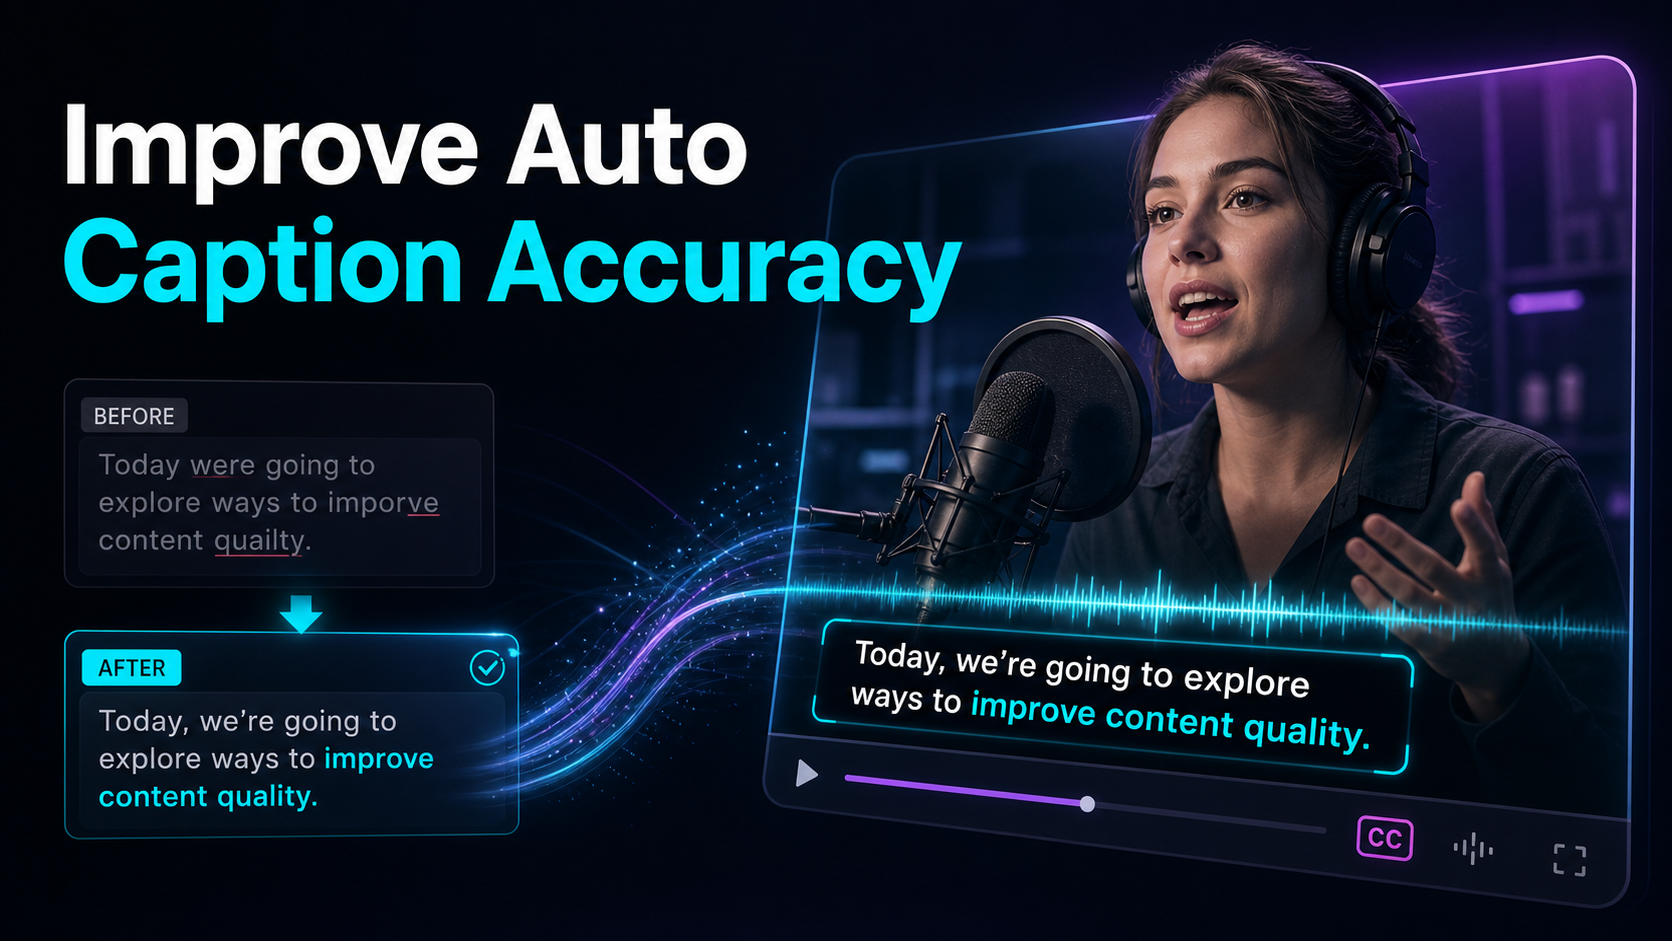
Automatyczne napisy mylą się z nazwami, przypadkowo się przerywają i źle słyszą całe frazy — a największe korzyści w poprawie dokładności automatycznych podpisów wynikają mniej z przełączania narzędzi, co z naprawianiem tego, co się do niego podaje. Zamiana mowy na tekst jest tak dobra, jak dźwięk, który słyszy, i słowa, których się spodziewa, dlatego ten przewodnik ściśle skupia się na dźwigniach, które faktycznie kontroluje twórca: czystszy dźwięk wejściowy, nawyki nagrywania, które transkrybent może stosować, niestandardową listę słów dla nazw i żargonu oraz szybką pętlę transkrypcji, edycji i eksportu, która łapie wszystko, co się przemknie. Czy te cztery i niedokładne podpisy stają się szybkim korektorem, a nie powtarzającym się bólem głowy?
Dlaczego automatyczne napisy stają się niedokładne — i jak poprawić ich dokładność
Zanim poprawisz automatyczne napisy, warto wiedzieć, dlaczego je nie ma. Każda funkcja auto-napisów działa na podstawie rozpoznawania mowy: model słucha twojego dźwięku, zgaduje najbardziej prawdopodobne słowa i przypisuje na nie czasy. Zawodzi w przewidywalny sposób — a większość tych błędów wynika z danych wejściowych, a nie z algorytmu.
| Przyczyna błędów Pod twoją kontrolą? Naprawa |
| Muzyka tła lub hałas pod mową | Tak | Oczyść dźwięk przed transkrybacją |
| Dwie osoby przekrzykujące się | Tak | Izoluj jeden głośnik na segment |
| Echo pokojowe / pogłos | Przeważnie | Nagrywaj bliżej, traktuj salę |
| Nazwy, marki, żargon, akronimy | Tak | Wprowadź niestandardową listę słów, sprawdź ją |
| Szybkie, mamrotane lub krótkie podanie | Tak | Zwolnij, wymów wyraźnie, mikrofon zamknięty |
| Silny akcent lub mowa obca | Częściowo | Wybierz transkrybenta, który się tym zajmie |
| Dźwięk o niskim przepływowości lub głośnikach telefonicznych | Tak | Nagraj do pliku czystego źródła |
Przeczytaj tę kolumnę odpowiedzi "tak" i strategia sama się zapisuje. Nie zawsze możesz zmienić akcent na nagraniu innej osoby, ale prawie zawsze możesz przekazać transkrybowi czystszy dźwięk i listę słów, które mogą się pomylić. To właśnie jest dźwignia — i dlatego gonienie za "mądrzejszym" narzędziem przed poprawą danych zwykle rozczarowuje.
Najpierw napraw wejście: czysty dźwięk do napisów
Oczyszczanie źródła dźwięku jest przydatną zmienną do testowania, ponieważ transkrybent może jedynie wyraźnie podpisać odebrany sygnał. Dominują dwa problemy.
Stały szum tła — szum HVAC, ruch uliczny, wentylatory laptopa, szum taśmy — czai się pod twoim głosem i rozmywa krawędzie słów, więc model zgaduje. Przepuszczenie ścieżki przez audio-noise-reduction przed transkrybacją powoduje obniżenie poziomu i daje modelowi czystszy sygnał. Zrób to na dźwięku źródłowym, a nie po napisach — celem jest poprawa tego, co transkrybent słyszy, a nie łatanie wyjścia.
Pod głosem jest muzyczne łóżko to bardziej podstępne. Muzyka dzieli przestrzeń częstotliwościową z mową, więc transkrybent próbujący napisać głowę mówiącą na tle podkładu upuszcza i źle słyszy słowa, które zagrałby na suchym wokalu. Jeśli Twoje nagranie zawiera mowy i muzykę zmiksowaną w jednej ścieżce, wyizoluj głos za pomocą stem-splitter, transkrybuj z czystego wokalu, a następnie przywróć muzykę do finalnego miksu. Podpisujesz głos, nie piosenkę walczącą z nim.
Kolejność ma znaczenie: najpierw czyste, potem transkrybować — odszumiany, wolny od muzyki wokal robi więcej dla dokładności niż jakiekolwiek późniejsze korekty. Jeśli czyszczenie dźwięku jest dla Ciebie nowością, nasz przewodnik jak oczyścić audio dla wideo obejmuje pełną kolejność działań.
Nagrywaj, aby transkrybent mógł śledzić
Połowa dokładności ustalana jest zanim w ogóle klikniesz "generuj", w momencie nagrywania. Transkrybent nie jest czytelnikiem myśli — podąża za najjaśniejszym sygnałem, jaki otrzymuje, a te nawyki nic nie kosztują.
- Mikrofon blisko, mikrofon stały. Źródło blisko głośnika i na stałym poziomie daje modelowi wyraźne spółgłoski — tam, gdzie większość błędów słownych się kryje — zamiast odległego, pokojowego koloru płynu.
- Jeden głośnik na raz. To przesłuch to miejsce, gdzie automatyczne napisy najszybciej się rozpadają. Gdy dwa głosy się nakładają, model nie może jednoznacznie przypisać żadnego z nich, więc zniekształca oba. W wywiadach coach gości pozwala, by wypadł beat przed odpowiedzią.
- Ujarmij pokój. Pogłos rozmazuje końcówki słów. Nagrywanie w miękko umeblowanym pomieszczeniu lub bliżej mikrofonu w jasnym pomieszczeniu odcina echo, przez które model musi się przebić.
- Wymów w ludzkim tempie. Nie potrzebujesz radiowej dykcji — wystarczy unikać bełkotów, urywanych lub pośpiesznych wypowiedzi, które nawet ktoś poprosiłby cię o powtórzenie. Jeśli jakieś słowo jest ważne (imię, liczba), trafiaj je czysto.
Stwórz niestandardową listę słów z nazwami i żargonem
Oto rozwiązanie, które większość twórców pomija, i to właśnie ono eliminuje błędy, które najbardziej cię zawstydzają. Rozpoznawanie mowy jest stronnicze na korzyść powszechnych słów. Podaj mu "Recapo", nazwisko klienta, SKU produktu lub niszowy akronim, a sięgnie po najbliższe codzienne słowo — dlatego podpisy skupiają się na rzeczownikach własnych i żargonie.
Fix ma dwie formy:
- Niestandardowy słownik, jeśli twoje narzędzie go obsługuje. Niektóre transkrypcje pozwalają rejestrować terminy — nazwy, marki, słownictwo techniczne — przed uruchomieniem zadania, więc model ich oczekuje. Gdy taka opcja jest dostępna, to najczystszy sposób, by za pierwszym razem poprawnie zaznaczyć imiona. Ładuj słowa, które Twój kanał mówi nieustannie: swoją własną markę, powtarzających się gości, żargon swojej niszy.
- Lista poprawek do ponownego użytku, jeśli nie. Brak pola słownika niestandardowego? Prowadź krótki plik tekstowy z terminami, które twój transkrybent zawsze przerabia, i jak powinny się czytać. Popraw je raz na każdy film podczas korekty, a ponieważ wklejasz z znanej listy, przejście trwa kilka sekund zamiast szukać.
Tak czy inaczej, zasada jest taka: transkrybent potrafi samodzielnie opanować zwykłą mowę; Twoim zadaniem jest podać mu kilka rzadkich słów, których nie potrafi odgadnąć. Ten jeden nawyk zamienia większość skarg na pytanie "dlaczego ciągle źle pisze moje imię" w rozwiązany problem.
Wybierz transkrybent, który pasuje do Twojego dźwięku
Nie każdy silnik przekształcający mowę w tekst radzi sobie z każdym rodzajem dźwięku równomiernie — akcenty, nakładająca się mowę, słownictwo techniczne i języki nieangielskie oddzielają te narzędzia. Ale nie ufaj procentowi "dokładności" marketingowej; Mierzono go na czystym dźwięku studyjnym, który nie wygląda jak twój. Zrób własny test.
Weź swoje najgorsze 60 sekund — gościa z akcentem, hałaśliwą lokalizację, fragment pełen żargonu — i przesłuchaj je przez dowolnego transkrybenta, którego rozważasz. Następnie oceń wynik na podstawie tego, co naprawdę się liczy:
- Rzeczowniki własne. Czy dobrze ustalił nazwy, marki i miejsca, czy wynalazł homofony?
- Interpunkcja i wielkie litery. Czy zdania są połamane rozsądnie, czy to jeden blok z rozciąganiem się?
- Edytowalność. Czy możesz poprawić transkrypcję na miejscu, najlepiej obok wideo, zamiast eksportować i importować ponownie?
- Timing na poziomie słowa. Czy oznacza czasy na słowo, a nie tylko na linijkę — dane potrzebne do precyzyjnych, dobrze zsynchronizowanych napisów?
- Języki, których faktycznie używasz. Jeśli podpisujesz w więcej niż jednym języku, czy to się sprawdza w każdem?
Narzędzie, które przekazuje prawdziwy dźwięk, będzie dla ciebie służyło; Taki, który błyszczy tylko na demo klipie, nie będzie. Uniwersalny ai-subtitle-generator, który tworzy edytowalny, czasowy zapis, daje najwięcej miejsca na poprawę pozostałych rzeczy. Aby uzyskać szerszy przegląd opcji, zobacz nasze zestawienie najlepszych generatorów automatycznych napisów.
Pętla korekty: gdzie umierają ostatnie błędy
Nawet przy czystym dźwięku i dobrej liście słów, żadna auto-napisowa przepustka nie jest gotowa do publikacji bez zmian — a krótkie napisy zostają wklejone do filmu, więc literówka staje się trwała. Ścisła pętla korekty to to, co stoi między "w większości poprawnym" a "faktycznie poprawnym".
- Wygeneruj transkrypcję. Przepuść oczyszczony dźwięk przez auto-captions, aby uzyskać napisy z czasową osi czasu na słowo — edytowalną wersję szkicu, którą poprawisz, nie ostatnie słowo.
- Najpierw zeskanuj tokeny wysokiego ryzyka. Nie czytasz każdego słowa ponownie; Szukasz czterech rzeczy, których najbardziej brakuje transkrybentom: imiona, homofony ("their/there", "do/two"), numbers (ceny, daty, statystyki) i żargon. Popraw je, a wykryjesz błędy, które faktycznie kosztują cię wiarygodność.
- Edycja obok filmu. Popraw w widoku transkrypcji, który odtwarza klip obok tekstu, żeby naprawić błędy w kontekście i potwierdzić, że czas nie przesunął się. To znacznie szybsze niż edytowanie surowego pliku napisów w ciemno.
- Przeczytaj raz, wyciszony. Odtwórz wideo wyciszony i przeczytaj tylko napisy, tak jak widz bez dźwięku — niektórzy widzowie napotykają krótkie filmy z wyłączonym dźwiękiem, zgodnie z wytycznymi dostępności platform. Wszystko, co jest źle czytane w ciszy, teraz jest naprawiane.
- Wypal i wyeksportuj. Dopiero gdy transkrypcja jest czysta, renderujesz podpisy w klatkach. Ponieważ wypalenie jest trwałe, korekta nigdy nie jest krokiem, który się pomija.
Ta pętla jest krótka z założenia: im czystszy jest twój wkład i lista słów, tym mniej jest tu do poprawienia.
Porady dotyczące dokładności podpisów na pierwszy rzut oka
Trzymaj tę listę kontrolną przy swoim workflow — to najkrótsza droga do lepszych automatycznych napisów. Większość problemów z celnością ginie, jeśli pobiegniesz na nią przed naciśnięciem generuj.
- Najpierw wyczyść dźwięk: odszumować i rozdzielić podkład muzyczny, żeby transkrybować suchy wokal.
- Nagrywaj blisko, równie i po jednym głosie naraz: minimalne przesłuchy i pogłos.
- Wprowadź niestandardową listę słów: marka, nazwy, żargon, akronimy — i przetestuj narzędzie na najgorszym klipie, a nie na czystej demonstracji.
- Sprawdź tokeny wysokiego ryzyka: imiona, homofony, liczby, żargon — i przeczytaj je wyciszony przed wpisaniem się, bo wypalone błędy są trwałe.
Gdzie Recapo pasuje
Recapo to przeglądarkowa przestrzeń robocze AI wideo — nic do zainstalowania — a cała pętla dokładności w tym przewodniku działa w niej od początku do końca. Możesz zmniejszyć hałas tła, oddzielić ścieżkę muzyczną od wokalu, przepisać i napisy do transkrypcji na poziomie słowa, edytowalnej, poprawić nazwy i liczby obok wideo, a następnie zmienić rozmiar do 9:16 i wyeksportować z napisami wypalonymi — wszystko w jednej zakładce, bez konieczności przenoszenia pliku między denoiserem, transkryberem i edytorem. Akceptuje pliki MP4, MOV i inne popularne formaty, łącznie do 6GB na zadanie.
Praktyczne dopasowanie: Recapo oczyszcza wejście i daje edytowalny transkrypcję, ale nie może wymyślić nazwy, której nigdy nie usłyszał, ani zdecydować, o który homofon chodzi. Te decyzje — niestandardowa lista słów, stonowane czytanie, ostateczna korekta — pozostają twoje i to właśnie one zamieniają dobrą auto-podpisową przejściową w czystą. Jeśli napisy są stałym elementem Twojej rutyny, to posiadanie czystego dźwięku, transkrypcji i korekty w jednej zakładce to zadanie, do którego są stworzone. Plany są dostępne na stronie z cenami.
FAQ
Dlaczego moje automatyczne napisy są tak niedokładne?
Prawie zawsze ze względu na dźwięk, a nie na narzędzie. Szum w tle, muzyczne łóżko pod głosem, nakładające się głośniki oraz mamrotane lub odległe wypowiedzi zmuszają model mowy do zgadywania, i to błędnie zgaduje trudne słowa. Imiona, marki i żargon dodają drugą warstwę, ponieważ rozpoznawalność jest uprzedzona na korzyść powszechnych słów. Czyść dźwięk, nagrywać z bliska jednym głosem na raz i podaj transkryberowi swoje nietypowe terminy — to naprawia większość niedokładnych napisów, zanim w ogóle zaczniesz korektę.
Czy poprawa dźwięku naprawdę poprawia dokładność napisów?
Tak, i zwykle to największe pojedyncze zwycięstwo. Transkrybent może podpisywać tylko to, co wyraźnie słyszy, więc stały hałas i konkurencyjna ścieżka muzyczna bezpośrednio powodują opuszczone i pomyłkowe słowa. Odcięcie źródła i izolacja głosu od jakiejkolwiek ścieżki muzycznej przed transkrypcją daje modelowi czystszy sygnał i usuwa błędy u źródła — znacznie skuteczniej niż późniejsza korekta wyniku.
Jak poprawić imiona i żargon w automatycznych napisach?
Na dwa sposoby. Jeśli Twój transkrybent obsługuje niestandardowy słownik, zarejestruj nazwy, marki i terminy techniczne przed uruchomieniem zadania, aby model ich oczekiwał. Jeśli nie, prowadź krótką, wielokrotnie używalną listę słów, które zawsze przekształca, i wklej poprawki podczas korekty. Każde z tych podejść zamienia błędy, które najbardziej Cię zawstydzają — własną markę czy źle napisane imię gościa — w rozwiązane, powtarzalne rozwiązanie.
Czy mogę poprawić dokładność bez ponownego nagrywania?
Często, tak. Możesz odszumować istniejący utwór, oddzielić płytę muzyczną od wokalu i przepuścić oczyszczony dźwięk przez transkrybator, który obsługuje Twój rodzaj mowy, a następnie sprawdzić wynik — wszystko to bez ponownego nagrywania. Ponowne nagrywanie przynosi efekty tylko wtedy, gdy problemem jest samo źródło (silne przesłuchy, silny pogłos lub przechwyt głośnika telefonicznego); W większości nagrań czyszczenie wejścia i korekta zamykają tę lukę.
Jakiej dokładności powinienem się spodziewać od automatycznych napisów?
Różni się zbyt bardzo, by obiecać liczbę — czysty, mikrofonowany z bliskim mikrofonem jednogłośnikowy transkrypcja jest znacznie lepszy niż głośne nagranie z wieloma użytkownikami, a wyniki różnią się w zależności od języka i akcentu. Zamiast ufać procentowemu wskaźnikowi nagłówków dostawcy, przetestuj dowolne narzędzie na swoich najgorszych 60 sekundach. Niezależnie od narzędzia, zaplanuj krótką korektę imion, homofonów i numerów przed włożeniem podpisów — to właśnie ten ostatni tekst sprawia, że są gotowe do publikacji.
Gotowy, by przestać walczyć z niedokładnymi podpisami? Stwórz darmowe konto, wgraj swoje nagrania — MP4 lub MOV, do 6GB na zadanie — i uruchom całą pętlę dokładności w jednej karcie przeglądarki: usuń szum, oddziel dowolną ścieżkę muzyczną, przepisz na tekst edytowalny transkrypcję, którą poprawisz obok wideo, a następnie przeformatuj do 9:16 i wyeksportuj z napisami wypalonymi. Przynosisz czysty dźwięk i ostateczny odczyt; Recapo zajmuje się produkcją, więc twoje następne przesłanie jest wysyłane z podpisami mówiącymi to, co faktycznie powiedziałeś.
Bibliografia i oficjalne źródła
- Pomoc YouTube: Dodaj napisy i napisy
- MDN Web Docs: WebVTT API
- Recapo.ai: Przegląd produktu i aktualne limity przesyłania
- Recapo.ai: AI Video Editor
- FFmpeg: Oficjalna dokumentacja