AI YouTube 썸네일 메이커
YouTube URL을 붙여넣거나 영상을 업로드하세요. AI가 영상 전체를 분석해 핵심 장면을 선별하고, 원한다면 내 사진까지 추가해 1~4개의 독립적인 16:9 썸네일을 생성합니다.

클릭 또는 드래그하여 영상 업로드
MP4, MOV, MPEG, MPG, 3GPP 또는 MKV
내 사진 포함
선택 사항
이미지 수
단순 색상 필터 반복이 아닌 독립적인 방향성
토킹 헤드 및 인터뷰 · 튜토리얼, 리뷰 및 제품 · 여행, 음식 및 얼굴 없는 영상
프레임 선택 전 영상 완벽 분석
균등하게 배치된 스크린샷은 종종 전환 구간, 감은 눈, 관련 없는 B-roll 또는 맥락 없는 이미지를 포착하곤 합니다. 이 워크플로는 영상 이해를 최우선으로 합니다. 콘텐츠가 튜토리얼, 인터뷰, 리뷰, 여행기, 게임, 설명 영상 등 어떤 유형인지 파악한 뒤, 시각적 요소, 행동, 음성 및 대사를 활용해 진정한 핵심 후크를 찾아냅니다.
- 01
링크 붙여넣기 또는 영상 업로드
YouTube URL을 입력하면 Recapo의 기존 링크-투-비디오 서비스가 활용되며, 로컬 영상 파일을 직접 선택할 수도 있습니다.
- 02
영상 분석 및 핵심 순간 선별
영상 요약 워크플로가 영상 전체의 유형, 주제, 대상, 사건 및 감정적 절정 부분을 분석하여 다양한 고가치 순간을 반환합니다.
- 03
1~4개의 독립적인 컨셉 선택
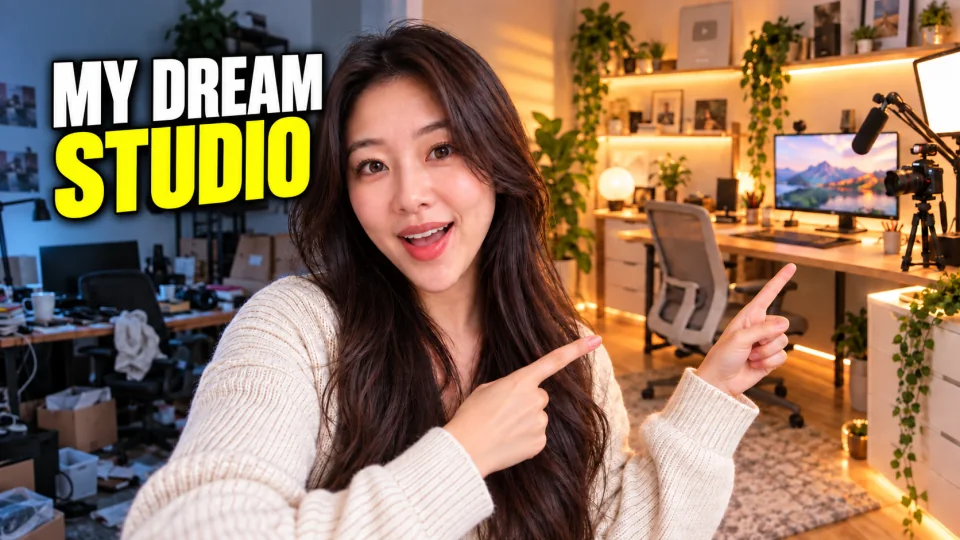
기본적으로 이미지 1개가 선택됩니다. 요청된 각 결과는 선택된 실제 프레임 하나를 사용해 독립적으로 편집되며, 원본 자막을 제거하고 실제 인물과 시네마토그래피를 보존한 뒤 명확한 영어 헤드라인을 추가합니다.
시각적으로 매력적이라도 관련 없는 프레임보다 콘텐츠 관련성이 우선입니다.
인물 중심 영상은 보이는 얼굴, 표정, 제스처 및 상호작용을 우선시하며, 얼굴 없는 영상은 대신 시각적 주목도를 활용합니다.
후보 프레임은 반복되는 단일 순간이 아닌 다양한 장면과 시간대에서 추출됩니다.
본인을 알아볼 수 있는 일관된 인물로 추가하기
업로드한 사진은 일반적인 스타일 이미지가 아닌 아이덴티티 참조로 처리됩니다. 생성 프롬프트는 썸네일 장면의 포즈와 조명에 맞추면서, 알아볼 수 있는 얼굴 구조, 이목구비, 피부톤, 머리 스타일 및 나이를 명시적으로 보존합니다. 최대 4MB 크기의 PNG, JPG, JPEG 및 WEBP 파일을 지원합니다.
- 링크 붙여넣기 또는 영상 업로드
- 영상 분석 및 핵심 순간 선별
- 1~4개의 독립적인 컨셉 선택
단순 색상 필터 반복이 아닌 독립적인 방향성
1개에서 4개 사이의 결과를 선택하세요. 요청된 모든 이미지는 자체 단일 프레임 편집에서 서로 다른 실제 키프레임을 사용합니다. 각 후보는 자체 앵커 프레임의 인물, 의상, 카메라 앵글 및 원래 시각적 스타일을 보존하면서 고유한 레이아웃과 헤드라인을 사용할 수 있습니다.
실제 작업 환경에 맞춘 설계
토킹 헤드 및 인터뷰
표정, 제스처 및 상호작용이 명확한 순간을 선택한 후, 선택적으로 본인 사진을 추가해 발표자를 강조할 수 있습니다.
튜토리얼, 리뷰 및 제품
기본적으로 발표자에 의존하는 대신, 핵심 사물, 작동 과정, 결과 또는 비포/애프터 대비를 시각적 초점으로 만드세요.
여행, 음식 및 얼굴 없는 영상
장면 및 사물의 주목도를 활용해 명확한 행동, 색상 대비 및 공간감이 드러나는 순간을 찾으세요.
자주 묻는 질문
도구는 어떻게 참조 프레임을 선택하나요?
Recapo는 영상 요약 워크플로를 재사용하여 영상 전체의 시각적 요소, 행동, 음성 및 대사를 파악한 뒤, 주제 및 핵심 후크와 연결된 타임스탬프를 반환합니다. 고정된 25%, 50%, 75% 위치를 캡처하는 대신 해당 순간의 원본 프레임을 추출합니다.
업로드한 사진은 어떻게 사용되나요?
대상 장면의 조명에 맞추면서 알아볼 수 있는 얼굴 구조, 이목구비, 피부톤, 머리 스타일 및 나이를 보존하라는 지시와 함께 별도의 아이덴티티 참조로 사용됩니다.
어떤 영상 입력을 지원하나요?
유효한 YouTube URL을 붙여넣거나 브라우저에서 읽을 수 있는 로컬 영상을 업로드하세요. URL 입력은 Recapo의 기존 링크-투-비디오 서비스를 재사용합니다.
썸네일은 몇 개 생성되나요?
1~4개의 결과를 선택할 수 있으며, 기본적으로 1개가 선택됩니다. 요청된 모든 이미지는 자체 작업으로 실행되며, 한 번의 생성에서 여러 프레임을 혼합하는 대신 실제 키프레임 하나를 사용합니다.
선택된 프레임이 최종 썸네일로 사용되나요?
네, 각 결과는 하나의 원본 프레임을 앵커로 사용합니다. 편집 과정은 실제 인물, 의상, 카메라 앵글 및 시네마토그래피를 보존하고, 동일한 생성 과정에서 원본 자막을 제거한 뒤 새로운 영어 헤드라인을 추가합니다.