Hoe je de nauwkeurigheid van automatische onderschriften kunt verbeteren (minder fouten)
Hoe je de nauwkeurigheid van automatische onderschriften verbetert: het invoergeluid schoonmaken, opnemen zodat transcribenten kunnen volgen, en een aangepaste woordenlijst voor namen invoeren.
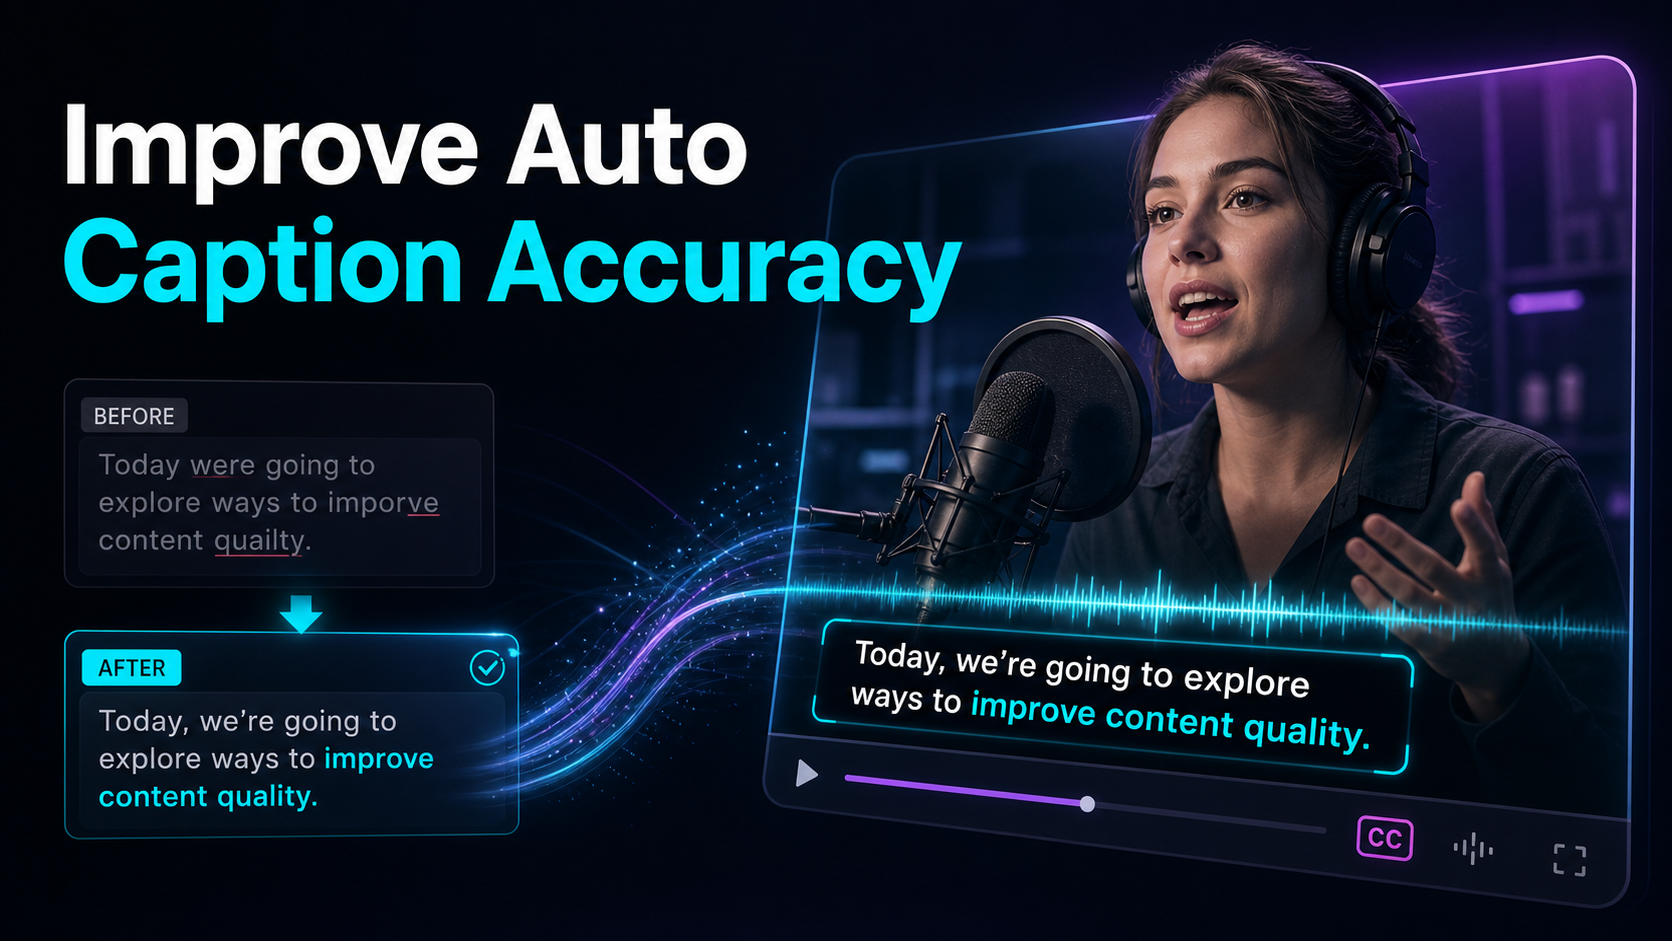
Auto-ondertitels geven namen fout, zetten willekeurige interpuncties en horen hele zinnen verkeerd — en de grootste successen op het gebied van het verbeteren van de nauwkeurigheid van automatische ondertitels komen minder door het wisselen van tools dan door het verbeteren van wat je het hulpmiddel geeft. Spraak-naar-tekst is alleen zo goed als het geluid dat het hoort en de woorden die het verwacht, dus deze gids houdt de handvatten die een maker daadwerkelijk bestuurt: schonere inputaudio, het opnemen van gewoonten die een transcribator kan volgen, een aangepaste woordenlijst voor namen en jargon, en een snelle transcribe-edit-export-lus die alles opvangt wat erdoorheen glipt. Worden die vier en onnauwkeurige bijschriften een snelle proeflees, geen terugkerende hoofdpijn.
Waarom automatische ondertitels onnauwkeurig worden — en hoe je de nauwkeurigheid van automatische onderschriften kunt verbeteren
Voordat je automatische ondertiteling kunt repareren, is het handig om te weten waarom ze missen. Elke automatische ondertekstfunctie draait op spraakherkenning: het model luistert naar je audio, raadt de meest waarschijnlijke woorden en stempelt er tijden op. Het faalt op voorspelbare manieren — en de meeste van die fouten zijn terug te voeren op de input, niet op het algoritme.
| Oorzaak van fouten Onder jouw controle? De oplossing |
| Achtergrondmuziek of ruis onder spraak | Ja | Maak de audio schoon voordat je ze transcribeert |
| Twee mensen die door elkaar heen praten | Ja | Isoleer één luidspreker per segment |
| Kamerecho / galm | Voornamelijk | Neem dichterbij op, behandel de kamer |
| Namen, merken, jargon, acroniemen, | Ja | Voer een aangepaste woordenlijst in, proeflees het |
| Snel, gemompeld of afgebroken voordracht | Ja | Langzamer, articuleer, microfoon dicht |
| Sterk accent of niet-moedertaalspraak | Gedeeltelijk | Kies een transcriber die dit afhandelt |
| Low-bitrate of telefoonluidspreker audio | Ja | Record naar een schoon bronbestand |
Lees die kolom met "ja"-antwoorden en de strategie schrijft zichzelf. Je kunt niet altijd een accent veranderen op iemands opname, maar je kunt de transcribator wel een schonere audio en een lijst van woorden geven die hij waarschijnlijk zal verbergen. Dat is de hefboomwerking — en waarom het najagen van een "slimmere" tool voordat je de input corrigeert meestal teleurstelt.
Herstel eerst de invoer: schone audio voor ondertiteling
Het schoonmaken van het brongeluid is een nuttige variabele om te testen, omdat een transcriber alleen het signaal dat hij ontvangt duidelijk kan ondertitelen. Twee problemen domineren.
Constant achtergrondgeluid — HVAC-gezoem, verkeer, laptopventilatoren, bandgeruis — zit onder je stem en vervaagt de randen van woorden, dus het model raadt. Het volgen van de track door audio-ruisreductie voordat je transcribeert] trekt die vloer naar beneden en geeft het model een schoner signaal. Doe dit op het brongeluid, niet na het ondertitelen — het doel is om te verbeteren wat de transcribator hoort, niet om de output te patchen.
Een muziekbed onder de stem is de stiepigste. Muziek deelt frequentieruimte met spraak, dus een transcribeerder die een pratende kop over een backing track probeert te onderschrijven, zal woorden verkeerd verstaan die hij op een droge zang zou hebben gepikt. Als je opname spraak en muziek in één spoor heeft gemixt, isoleer dan de stem met stem-splitter, transcribeer van de schone zang, en breng de muziek terug voor de eindmix. Je onderschrijft de stem, niet het lied dat ertegen vecht.
De volgorde is belangrijk: eerst schoonmaken, daarna transscriberen — een ontruisde, muziekvrije zang doet meer voor de nauwkeurigheid dan enige correctie achteraf. Als audio-cleanup nieuw voor je is, behandelt onze walkthrough over hoe je audio voor video schoonmaakt] de volledige volgorde van bewerkingen.
Leg op zodat de transcribator kan volgen
De helft van de nauwkeurigheid wordt bepaald voordat je op "genereren" drukt, op het moment van opnemen. Een transcribeerder is geen gedachtenlezer — hij volgt het duidelijkste signaal dat hij krijgt, en deze gebruiken kosten niets.
- Microfoon dichtbij, microfoon consistent. Een bron dicht bij de luidspreker en op een constant niveau geeft het model scherpe medeklinkers — waar de meeste woordfouten verbergen — in plaats van een verre, kamerkleurige wash.
- Eén spreker tegelijk. Crosstalk is waar automatische ondertiteling het snelst uit elkaar valt. Wanneer twee stemmen overlappen, kan het model geen van beide duidelijk toeschrijven, waardoor beide worden verstoord. In interviews coach je gasten om een beat te laten landen voordat je antwoordt.
- Tam the room. Reverb vervaagt woorduitgangen. Opnemen in een zacht ingerichte ruimte, of dichter bij de microfoon in een heldere, snijdt de echo weg waar het model doorheen moet vechten.
- Articuleer in een menselijk tempo. Je hebt geen radiodictie nodig — vermijd gewoon de gemompelde, afgemeten of gehaaste levering die zelfs iemand je zou vragen te herhalen. Als een woord belangrijk is (een naam, een nummer), plaats het dan netjes.
Maak een aangepaste woordenlijst voor namen en jargon
Hier is de oplossing die de meeste makers overslaan, en die is degene die de fouten die je het meest in verlegenheid brengen, doodt. Spraakherkenning is bevooroordeeld ten gunste van gewone woorden. Voer het "Recapo", de achternaam van een klant, een product-SKU of een nicheacroniem, en het grijpt in plaats daarvan naar het dichtstbijzijnde alledaagse woord — daarom zijn eigennamen en jargon waar onnauwkeurige bijschriften zich verzamelen.
De fix heeft twee vormen:
- Een aangepast woordenboek, als je tool die ondersteunt. Sommige transcribators laten je termen registreren — namen, merken, technische woordenschat — voordat je de klus uitvoert, dus het model verwacht ze. Als die optie bestaat, is het de schoonste manier om de namen meteen goed te krijgen. Laad constant de woorden die je kanaal zegt: je eigen merk, terugkerende gasten, het jargon van jouw niche.
- Een herbruikbare correctielijst, als dat niet zo is. Geen aangepast woordenboekveld? Houd een kort tekstbestand bij met de termen die je transcribeerder altijd verwart en hoe ze moeten lezen. Repareer ze één keer per video tijdens het proeflezen, en omdat je van een bekende lijst plakt, duurt de pass slechts seconden in plaats van een zoektocht.
Hoe dan ook, het principe geldt: de transcribeerder kan gewone spraak zelf onder de knie krijgen; Jouw taak is om het een handvol ongewone woorden te geven die het niet kan raden. Die ene gewoonte verandert de meeste klachten van "waarom wordt mijn naam steeds verkeerd gespeld" in een opgelost probleem.
Kies een transcriber die bij je audio past
Niet elke spraak-naar-tekst-engine behandelt elk soort audio gelijk — accenten, overlappende spraak, technische woordenschat en niet-Engelse talen scheiden de tools allemaal van elkaar. Maar vertrouw niet op een marketingpercentage van "nauwkeurigheid"; Het werd gemeten op schone studioaudio die totaal niet op die van jou lijkt. Doe in plaats daarvan je eigen test.
Neem je slechtste 60 seconden — de gast met accent, de lawaaierige locatie, het jargonrijke segment — en laat die door elke transcribeerder lopen die je weegt. Beoordeel vervolgens de output op wat er echt toe doet:
- Eigennaam. Heeft het namen, merken en plaatsen goed gekregen, of homofonen uitgevonden?
- Interpunctie en casing. Worden zinnen verstandig gebroken, of is het één doorlopende blok?
- Bewerkbaarheid. Kun je het transcript corrigeren, idealiter naast de video, in plaats van te exporteren en opnieuw te importeren?
- Woordniveau-timing. Stempelt het timings per woord aan, niet alleen per regel — de data die je nodig hebt voor strakke, goed gesynchroniseerde onderschriften?
- Talen die je daadwerkelijk gebruikt. Als je in meer dan één taal onderschrift zet, houdt dat dan stand in elke taal?
Een tool die je echte audio doorgeeft, zal je dienen; Eentje die alleen uitblinkt op een democlip doet dat niet. Een algemeen gebruik ai-subtitle-generator) die een bewerkbare, woordgetimede transcriptie produceert, geeft je de meeste ruimte om te corrigeren wat er nog is. Voor een bredere overzicht van opties, zie onze overzicht van de beste automatische ondertekstgenerators].
De proefleeslus: waar de laatste fouten sterven
Zelfs met schone audio en een goede woordenlijst blijft geen enkele automatische onderschriftspass, die niet wordt gepubliceerd — en korte ondertitels worden in de video gebrand, waardoor een typfout permanent wordt. Een strakke proefleeskring is wat tussen "grotendeels goed" en "eigenlijk juist" staat.
- Genereer het transcript. Haal je schoongemaakte audio door auto-captions om getimede ondertitels met een tijdlijn per woord te krijgen — de bewerkbare versie die je corrigeert, niet het laatste woord.
- Scan eerst de risicovolle tokens. Je leest niet elk woord opnieuw; Je zoekt naar de vier dingen die transcribenten het meest missen: namen, homofonen ("hun/daar," "aan/twee"), cijfers (prijzen, data, statistieken) en jargon. Herstel die en je hebt de fouten ontdekt die je geloofwaardigheid daadwerkelijk kosten.
- Bewerk naast de video. Correct in een transcriptweergave die de clip naast de tekst afspeelt, zodat je mishears in context corrigeert en bevestigt dat de timing niet is afgedwaald. Dit is veel sneller dan blind een ruwe ondertitelbestand bewerken.
- Lees het één keer, op mute. Speel de video op mute en lees alleen de ondertiteling, zoals een kijker zonder geluid zou doen — sommige kijkers ervaren korte video's zonder geluid, volgens de toegankelijkheidsrichtlijnen van de platforms. Alles wat verkeerd leest, wordt nu stilletjes opgelost.
- Inbranden en exporteren. Pas nadat het transcript schoon is, render je de bijschriften in de frames. Omdat burn-in permanent is, sla je nooit de stap over het proeflezen.
Die lus is opzettelijk kort: hoe schoner je invoer en woordenlijst, hoe minder er te corrigeren is.
Tips voor nauwkeurigheid van de bijschriften in één oogopslag
Houd deze checklist naast je workflow — het is de kortste route naar betere automatische ondertiteling. De meeste nauwkeurigheidsproblemen verdwijnen als je het opgebruikt voordat je op genereren drukt.
- Maak eerst het geluid schoon: denoise, en splits het muziekbed zodat je een droge zang transcribeert.
- Neem dichtbij, vlak en één stem tegelijk op: minimale crosstalk en galm.
- Voer een aangepaste woordenlijst in: merk, namen, jargon, acroniemen — en test de tool op je slechtste clip, niet op een schone demo.
- Proeflees de risicovolle tokens: namen, homofonen, cijfers, jargon — en lees het gedempt voordat je inbrandt, want ingebrande fouten zijn permanent.
Waar Recapo past
Recapo is een browsergebaseerde AI-videowerkruimte — niets te installeren — en de hele nauwkeurigheidsloop in deze gids loopt er van begin tot eind in. Je kunt achtergrondgeluid verminderen, een muziekbed van de zang splitsen, het transcriberen en onderschrift op woordniveau, bewerkbare transcriptie gebruiken, namen en nummers naast de video nalezen, dan verkleinen naar 9:16 en exporteren met de onderschriften ingebrande — allemaal in één tabblad, zonder een bestand te wisselen tussen een denoiser, een transcribator en een editor. Het accepteert MP4, MOV en andere gangbare formaten, tot 6GB per taak in totaal.
De praktische aansluiting: Recapo zuivert de invoer en geeft je een bewerkbare transcriptie, maar kan geen naam verzinnen die hij nooit heeft gehoord of beslissen welke homofoon je bedoelde. Die oordeelskeuzes — de aangepaste woordenlijst, de gedempte lees, de laatste proefleeservaring — blijven van jou, en zij zijn wat een goede automatische ondertekst-pass in een schone versie verandert. Als ondertiteling een terugkerend onderdeel van je routine is, is het voor schone audio, transcriberen en proeflezen in één tabblad de taak waarvoor het gemaakt is. Plannen staan live op de prijspagina.
FAQ
Waarom zijn mijn automatische ondertitels zo onnauwkeurig?
Bijna altijd vanwege het geluid, niet door het gereedschap. Achtergrondgeluid, een muziekbed onder de stem, overlappende luidsprekers en gemompelde of verre voordracht dwingen het spraakmodel om te raden, en het raadt verkeerd op de moeilijke woorden. Namen, merken en jargon voegen een tweede laag toe, omdat herkenning bevooroordeeld is ten gunste van gewone woorden. Maak het geluid schoon, neem dichterbij op met één stem tegelijk, en geef de transcribator je ongebruikelijke termen — dat corrigeert de meeste onnauwkeurige onderschriften voordat je het proefleest.
Verbetert het opschonen van audio echt de nauwkeurigheid van onderschriften?
Ja, en het is meestal de grootste enkele overwinning. Een transcriber kan alleen onderschriften geven wat hij duidelijk hoort, dus constante ruis en een concurrerend muzieknummer veroorzaken direct gevallen en foutieve woorden. Het ontruisen van de bron en het isoleren van de stem van elk muziekbed voordat je het transcribeert, geeft het model een schoner signaal en vermindert fouten bij de wortel — veel effectiever dan het corrigeren van de output achteraf.
Hoe los ik namen en jargon op in automatische ondertiteling?
Twee manieren. Als je transcribator een aangepast woordenboek ondersteunt, registreer dan de namen, merken en technische termen voordat je de taak uitvoert zodat het model ze verwacht. Als dat niet zo is, houd dan een korte herbruikbare lijst bij van de woorden die het altijd verminkt en plak de correcties tijdens het proeflezen. Beide benaderingen veranderen de fouten die je het meest in verlegenheid brengen — je eigen merk of de naam van een gast verkeerd gespeld — in een opgeloste, herhaalbare oplossing.
Kan ik de nauwkeurigheid verbeteren zonder opnieuw op te nemen?
Vaak, ja. Je kunt het bestaande spoor denoiseen, een muziekbed van de zang splitsen en de gereinigde audio door een transcriber laten lopen die jouw soort spraak verwerkt, waarna je het resultaat proefleest — allemaal zonder iets opnieuw op te nemen. Heropname loont alleen wanneer de bron zelf het probleem is (veel crosstalk, ernstige galm of een telefoonluidspreker-opname); Voor de meeste beelden sluit het schoonmaken van de invoer en het proeflezen de kloof over.
Welke nauwkeurigheid kan ik verwachten van automatische onderteksten?
Het varieert te veel om een aantal te beloven — schone, dicht gemicrofoneerde single-speaker audio transcribeert veel beter dan een lawaaierige multi-speaker opname, en de resultaten verschillen per taal en accent. In plaats van te vertrouwen op het percentage koppen van een leverancier, test je elk hulpmiddel op je eigen slechtste 60 seconden. Wat het gereedschap ook is, reken op een korte proeflees van namen, homofonen en cijfers voordat je onderschriften inbrandt — die laatste keer maakt ze publiceerklaar.
Klaar om te stoppen met het bestrijden van onnauwkeurige bijschriften? [Maak een gratis account aan, upload je beelden — MP4 of MOV, tot 6GB per taak — en voer de hele nauwkeurigheidsloop uit in één browsertab: ruis verwijderen, een muziekbed afsplitsen, transcribeer naar een tekstniveau bewerkbare transcriptie die je naast de video proefleest, dan opnieuw kaderen naar 9:16 en exporteren met ingebrande ondertiteling. Je brengt de schone audio en de laatste lezing; Recapo verzorgt de productie, dus je volgende upload wordt geleverd met onderschriften die zeggen wat je daadwerkelijk zei.
Referenties en officiële bronnen
- YouTube Help: Voeg ondertitels en ondertitels toe
- MDN Web Docs: WebVTT API
- Recapo.ai: Productoverzicht en huidige uploadlimieten
- Recapo.ai: AI Video Editor
- FFmpeg: Officiële documentatie