Cómo mejorar la precisión de los subtítulos automáticos (menos errores)
Cómo mejorar la precisión de los subtítulos automáticos: limpia el audio de entrada, graba para que los transcriptores puedan seguir, introduce una lista personalizada de palabras para los nombres.
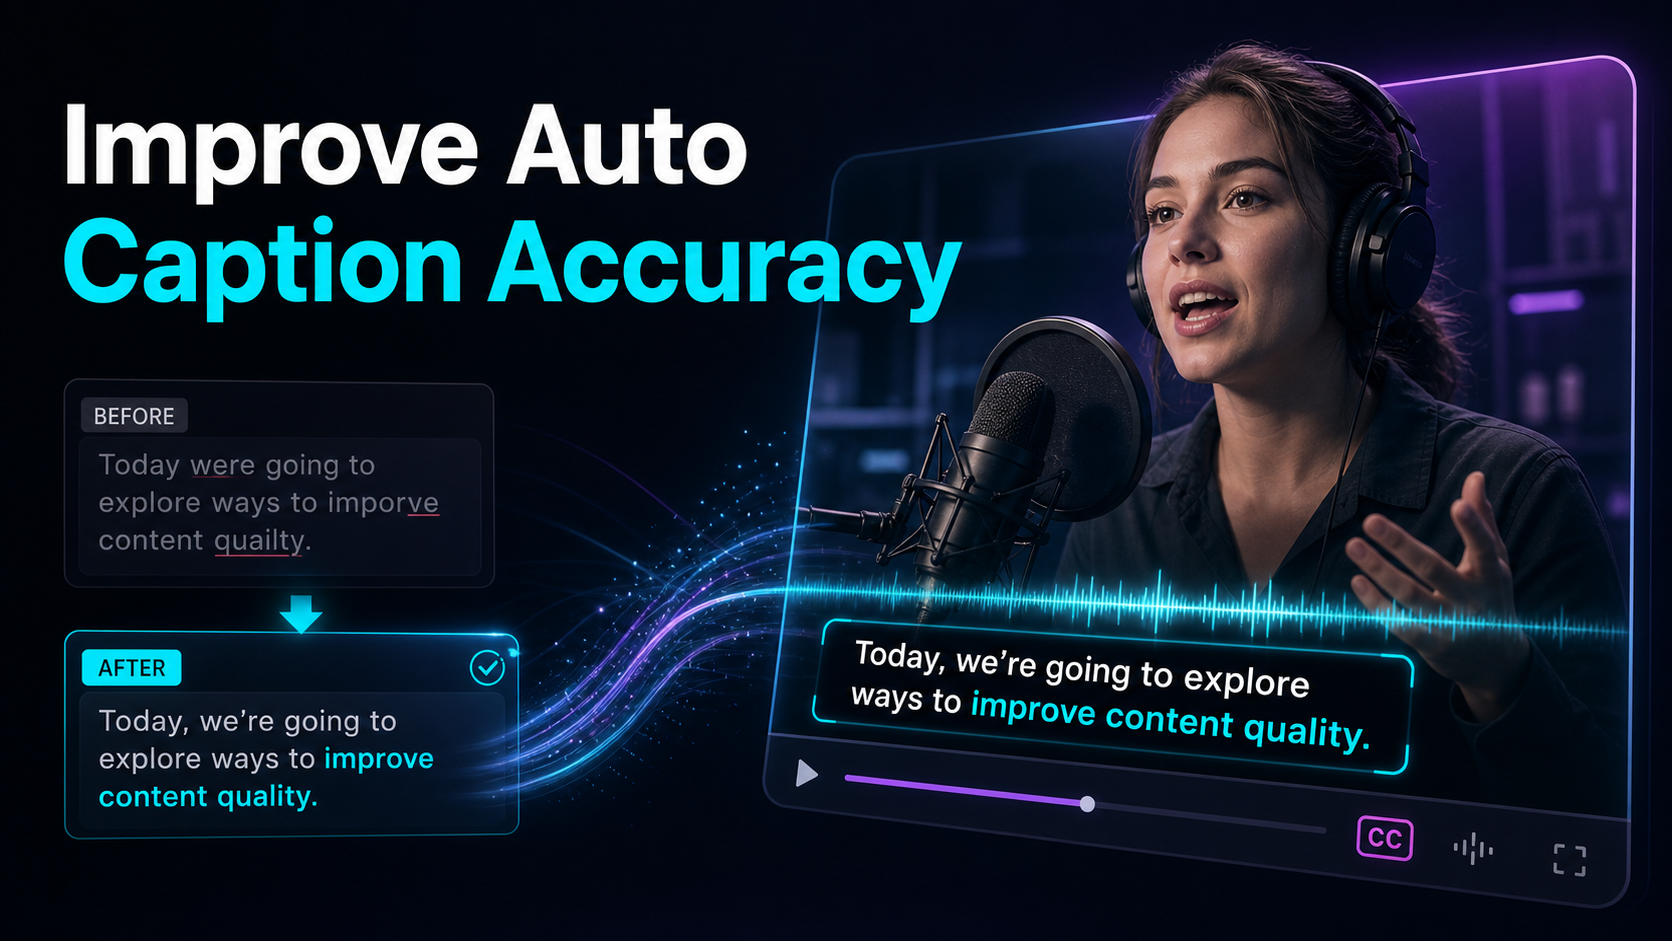
Los subtítulos automáticos se equivocan en los nombres, ponúan puntos al azar y malinterpretan frases enteras — y los mayores logros para mejorar la precisión de los subtítulos automáticos no vienen tanto de cambiar de herramienta como de arreglar lo que le das a la herramienta. La conversión de voz a texto solo es tan buena como el audio que escucha y las palabras que espera, así que esta guía se mantiene estricta en las palancas que realmente controla un creador: audio de entrada más limpio, hábitos de grabación que puede seguir un transcriptor, una lista personalizada de palabras para nombres y jerga, y un bucle rápido de transcripción-edición-exportación que detecta lo que se le escapa. ¿Esos cuatro y pies de foto inexactos se convierten en una corrección rápida, no en un dolor de cabeza recurrente?
Por qué los subtítulos automáticos se vuelven inexactos — y cómo mejorar la precisión de los subtítulos automáticos
Antes de poder arreglar los subtítulos automáticos, ayuda saber por qué fallan. Todas las funciones de subtítulos automáticos funcionan con reconocimiento de voz: el modelo escucha tu audio, adivina las palabras más probables y marca los tiempos en ellas. Falla de formas predecibles — y la mayoría de esos fallos se remiten a la entrada, no al algoritmo.
| Causa de los errores ¿Bajo tu control? La solución |
| Música de fondo o ruido bajo la voz | Sí | Limpia el audio antes de transcribir |
| Dos personas hablando una a la vez | Sí | Aislar un altavoz por segmento |
| Eco de habitación / reverberación | Mayormente | Graba más de cerca, da un capricho a la habitación |
| Nombres, marcas, jerga, siglas | Sí | Introduce una lista de palabras personalizada, corrección |
| Entrega rápida, murmurada o cortante | Sí | Ralentiza, pronuncia, micrófono |
| Acento fuerte o habla no nativa | En parte | Elige un transcriptor que lo maneje |
| Audio de baja tasa de bits o altavoz de teléfono | Sí | Grabar en un archivo fuente limpio |
Lee esa columna de respuestas "sí" y la estrategia se escribe sola. No siempre puedes cambiar un acento en la grabación de otra persona, pero casi siempre puedes entregar al transcriptor un audio más limpio y una lista de las palabras que probablemente falle. Esa es la palanca — y por eso perseguir una herramienta "más inteligente" antes de corregir la entrada suele decepcionar.
Arregla primero la entrada: audio limpio para los subtítulos
Limpiar el audio fuente es una variable útil para probar porque un transcriptor solo puede subtitular claramente la señal que recibe. Dos problemas dominan.
Ruido de fondo constante — zumbido de climatización, tráfico, ventiladores de portátil, siseo de cinta — se siente bajo tu voz y difumina los bordes de las palabras, para que el modelo adivine. Pasar la pista por audio-noise-reduction antes de transcribir baja ese suelo y entrega al modelo una señal más limpia. Hazlo en el audio original, no después de subtitular: el objetivo es mejorar lo que escucha el transcriptor, no parchear la salida.
Un fondo musical bajo la voz es el más sigiloso. La música comparte espacio de frecuencia con el habla, así que un transcriptor que intenta subtitular un parlante sobre una pista de acompañamiento soltará y malinterpretará palabras que habría clavado en una voz seca. Si tu grabación tiene voz y música mezcladas en una sola pista, aísla la voz con stem-splitter], transcribe la voz limpia y luego regresa la música para la mezcla final. Tú pones pie de foto a la voz, no la canción luchando contra ella.
El orden importa: primero limpiar, transcribir después — una voz sin ruido y sin música aporta más precisión que cualquier corrección a posteriori. Si la limpieza de audio es nueva para ti, nuestra guía sobre cómo limpiar audio para video] cubre todo el orden de operaciones.
Graba para que el transcriptor pueda seguir
La mitad de la precisión se decide antes de pulsar "generar", en el momento de grabar. Un transcriptor no es un lector de mentes: sigue la señal más clara que se le da, y estos hábitos no cuestan nada.
- Micrófono cerca, micrófono consistente. Una fuente cerca del altavoz y a un nivel constante da al modelo consonantes nítidas — donde se esconden la mayoría de los errores de palabras — en lugar de un lavado lejano color de la habitación.
- Un altavoz a la vez. La diafonia es donde los subtítulos automáticos se deshacen más rápido. Cuando dos voces se solapan, el modelo no puede atribuir limpiamente ninguna de las dos, así que distorsiona ambas. En entrevistas, los invitados en autobús dejan caer un ritmo antes de responder.
- Domar la habitación. La reverberación mancha las terminaciones de las palabras. Grabar en un espacio suave, o más cerca del micrófono en uno brillante, corta el eco que el modelo tiene que resistir.
- Articula a paso humano. No necesitas dicción radiofónica — solo evita la voz murmurada, cortante o apresurada que incluso alguien te pediría repetir. Si una palabra es importante (un nombre, un número), acríbela limpiamente.
Crea una lista personalizada de palabras para nombres y jerga
Aquí está la solución que la mayoría de los creadores se saltan, y es la que elimina los errores que más te avergüenzan. El reconocimiento de voz está sesgado hacia palabras comunes. Alimenta con "Recapo", el apellido de un cliente, un SKU de producto o un acrónimo de nicho, y buscará la palabra cotidiana más cercana — por eso los nombres propios y la jerga son donde se agrupan los pies de foto inexactos.
La solución tiene dos formas:
- Un diccionario personalizado, si tu herramienta lo soporta. Algunos transcriptores te permiten registrar términos — nombres, marcas, vocabulario técnico — antes de ejecutar el trabajo, para que el modelo los espere. Cuando existe esa opción, es la forma más limpia de acertar los nombres a la primera. Carga constantemente las palabras que dice tu canal: tu propia marca, invitados recurrentes, la jerga de tu nicho.
- Una lista de correcciones reutilizable, si no lo hace. ¿No hay campo de diccionario personalizado? Guarda un archivo de texto corto con los términos que tu transcriptor siempre manipula y cómo deben interpretarse. Arrégjalos una vez por vídeo durante la corrección, y como estás pegando desde una lista conocida, el pase tarda segundos en vez de una búsqueda.
En cualquier caso, el principio se mantiene: el transcriptor puede clavar el habla ordinaria por sí solo; Tu trabajo es darle el puñado de palabras poco comunes que no puede adivinar. Ese único hábito convierte la mayoría de las quejas de "por qué sigue escribiendo mal mi nombre" en un problema resuelto.
Elige un transcriptor que se adapte a tu audio
No todos los motores de reconocimiento de voz gestionan todos los tipos de audio por igual: los acentos, el habla superposta, el vocabulario técnico y los idiomas no ingleses separan las herramientas. Pero no confíes en un porcentaje de "precisión" en marketing; Se midió con audio limpio de estudio que no se parece en nada al tuyo. Haz tu propia prueba en su lugar.
Toma tus peores 60 segundos — el invitado con acento, la localización ruidosa, el segmento cargado de jerga — y pásalo por cualquier transcriptor que estés pesando. Luego puntua la salida según lo que realmente importa:
- Nombres propios. ¿Acertó con nombres, marcas y lugares, o inventó homófonos?
- Puntuación y mayúsculas. ¿Se rompen las frases de forma sensata, o es un bloque interminable?
- Editabilidad. ¿Puedes corregir la transcripción en su sitio, idealmente junto al vídeo, en lugar de exportar y reimportar?
- Tiempo a nivel de palabra. ¿Marca los tiempos por palabra, no solo por línea — los datos que necesitas para subtítulos precisos y bien sincronizados?
- Idiomas que realmente usas. Si subtitulas en más de un idioma, ¿se mantiene en cada uno?
Una herramienta que transmita tu audio real te servirá; Una que solo brilla en un clip de demo no lo hará. Un generador de subtítulos de IA AI-subtitle-generator] que produce una transcripción editable y sincronizada con palabra te da más margen para corregir lo que queda. Para una visión más amplia de opciones, consulta nuestro resumen de los mejores generadores de auto-subtítulos].
El bucle de corrección: donde mueren los últimos errores
Incluso con un audio limpio y una buena lista de palabras, ningún auto-subtítulo está listo para publicar sin tocar — y los subtítulos cortos quedan grabados en el vídeo, por lo que un error tipográfico se vuelve permanente. Un ciclo de corrección muy ajustado es lo que separa "mayormente correcto" y "realmente correcto".
- Genera la transcripción. Pasa tu audio limpio por auto-captions para obtener subtítulos cronometrados con una línea de tiempo por palabra — el borrador editable lo corregirás, no la palabra final.
- Escanea primero los tokens de alto riesgo. No relees cada palabra; Buscas las cuatro cosas que más se pierden los transcriptores: nombres, homófonos ("their/there", "to/two"), números (precios, fechas, estadísticas) y jerga. Corrige esos errores y detectarás los errores que realmente te han costado credibilidad.
- Edito junto al vídeo. Correcto en una vista de transcripción que reproduce el clip junto al texto, para corregir los errores en el contexto y confirmar que el tiempo no se desvió. Esto es mucho más rápido que editar un archivo de subtítulos sin editar a ciegas.
- Léelo una vez, silenciado. Reproduce el vídeo en silencio y solo los subtítulos, como haría un espectador sin sonido — algunos espectadores se encuentran con vídeos cortos con el sonido apagado, según las propias directrices de accesibilidad de las plataformas. Cualquier cosa que suena mal ahora se arregla en silencio.
- Grabar y exportar. Solo después de que la transcripción esté limpia renderizas los subtítulos en los fotogramas. Como el burn-in es permanente, la revisión nunca es el paso que se salta.
Ese bucle es corto por diseño: cuanto más limpia sea tu entrada y la lista de palabras, menos hay que corregir aquí.
Consejos de precisión de subtítulos de un vistazo
Mantén esta lista de comprobación junto a tu flujo de trabajo — es la ruta más corta para mejorar los subtítulos automáticos. La mayoría de los problemas de precisión mueren si lo acabas antes de llegar a generar.
- Limpia primero el audio: reduce el ruido y separa cualquier base musical para transcribir una voz seca.
- Graba de cerca, nivelado y una voz a la vez: mínima interfonía y reverberación.
- Introduce una lista personalizada de palabras: marca, nombres, jerga, siglas — y prueba la herramienta en tu peor clip, no en una demo limpia.
- Revisa los tokens de alto riesgo: nombres, homófonos, números, jerga — y léelo en silencio antes de quemar, porque los errores grabados son permanentes.
Dónde encaja Recapo
Recapo es un espacio de trabajo de vídeo con IA basado en navegador — nada que instalar — y todo el bucle de precisión de esta guía se ejecuta dentro de él de principio a fin. Puedes reducir el ruido de fondo, separar una base musical de la voz, transcribir y subtitular a una transcripción editable a nivel de palabra, corregir nombres y números junto al vídeo, luego redimensionar a 9:16 y exportar con los subtítulos grabados — todo en una sola pestaña, sin tener que mover un archivo entre un desruidosor, un transcriptor y un editor. Acepta MP4, MOV y otros formatos comunes, hasta 6GB totales por tarea.
La opción práctica: Recapo limpia la entrada y te da una transcripción editable, pero no puede inventar un nombre que nunca haya oído ni decidir a qué homófono te referías. Esas decisiones — la lista personalizada de palabras, la lectura silenciosa, la revisión final — siguen siendo tuyas, y son las que convierten un buen pase de subtítulos automáticos en uno limpio. Si el subtitulado es una parte recurrente de tu rutina, tener audio limpio, transcripción y corrección en una sola pestaña es el trabajo para el que está diseñado. Los planes están en la página de precios.
Preguntas frecuentes
¿Por qué mis subtítulos automáticos son tan inexactos?
Casi siempre por el audio, no por la herramienta. El ruido de fondo, una base musical bajo la voz, altavoces superpuestos y murmullos o una voz lejana, todo ello obliga al modelo de habla a adivinar, y se equivoca en las palabras difíciles. Los nombres, las marcas y la jerga añaden una segunda capa, porque el reconocimiento está sesgado hacia palabras comunes. Limpia el audio, graba más cerca con una voz a la vez y alimenta al transcriptor con términos poco comunes — eso corrige la mayoría de los subtítulos inexactos antes de que lo revises.
¿Realmente mejora la precisión de los subtítulos limpiar el audio?
Sí, y normalmente es la mayor victoria individual. Un transcriptor solo puede poner leyendas lo que puede oír claramente, así que el ruido constante y una pista musical competidora provocan directamente palabras caídas y erróneas. Reducir el ruido de la fuente y aislar la voz de cualquier base musical antes de transcribir proporciona al modelo una señal más limpia y elimina errores en la raíz — mucho más eficazmente que corregir la salida después.
¿Cómo arreglo los nombres y la jerga en los subtítulos automáticos?
De dos maneras. Si tu transcriptor soporta un diccionario personalizado, registra los nombres, marcas y términos técnicos antes de ejecutar el trabajo para que el modelo los espere. Si no es así, mantén una lista corta y reutilizable de las palabras que siempre destroza y pega las correcciones durante la corrección. Cualquiera de los dos enfoques convierte los errores que más te avergüenzan — tu propia marca o el nombre de un invitado mal escrito — en una solución resuelta y repetible.
¿Puedo mejorar la precisión sin volver a grabar?
A menudo, sí. Puedes eliminar el ruido de la pista existente, separar una base musical de la voz y pasar el audio limpio por un transcriptor que maneje tu tipo de habla, y luego corregir el resultado — todo sin grabar nada de nuevo. La regrabación solo da resultado cuando la propia fuente es el problema (diafonía intensa, reverberación severa o captura de altavoz del teléfono); Para la mayoría de las grabaciones, limpiar la entrada y corregir la prueba cierra el vacío.
¿Qué precisión debería esperar de los subtítulos automáticos?
Varía demasiado para prometer un número — el audio limpio y con micrófono cercano con un solo altavoz transcribe mucho mejor que una grabación ruidosa con varios altavoces, y los resultados varían según el idioma y el acento. En lugar de fiarte del porcentaje de titulares de un vendedor, prueba cualquier herramienta en tus peores 60 segundos. Sea cual sea la herramienta, prepárate con una breve revisión de nombres, homófonos y números antes de grabar los pies de foto — esa última revisión es lo que los hace listos para publicar.
¿Listo para dejar de pelear contra los subtítulos inexactos? Crea una cuenta gratuita, sube tu metraje — MP4 o MOV, hasta 6GB por tarea — y ejecuta todo el bucle de precisión en una sola pestaña del navegador: eliminar el ruido, separar cualquier base musical, transcribir a una transcripción editable a nivel de palabra que revises junto al vídeo, luego reencuadrar a 9:16 y exportar con los subtítulos grabados. Tú traes el audio limpio y la lectura final; Recapo se encarga de la producción, así que tu próxima subida viene con leyendas que dicen lo que realmente has dicho.
Referencias y fuentes oficiales
- Ayuda en YouTube: Añadir subtítulos y leyendas
- Documentación web MDN: WebVTT API
- Recapo.ai: Resumen del producto y límites actuales de subida
- Recapo.ai: Editor de vídeo IA
- FFmpeg: Documentación oficial