Comment améliorer la précision des sous-titres automatiques (moins d’erreurs)
Comment améliorer la précision des sous-titres automatiques : nettoyez l’audio d’entrée, enregistrez pour que les transcripteurs suivent, fournissez une liste de mots personnalisée pour les noms.
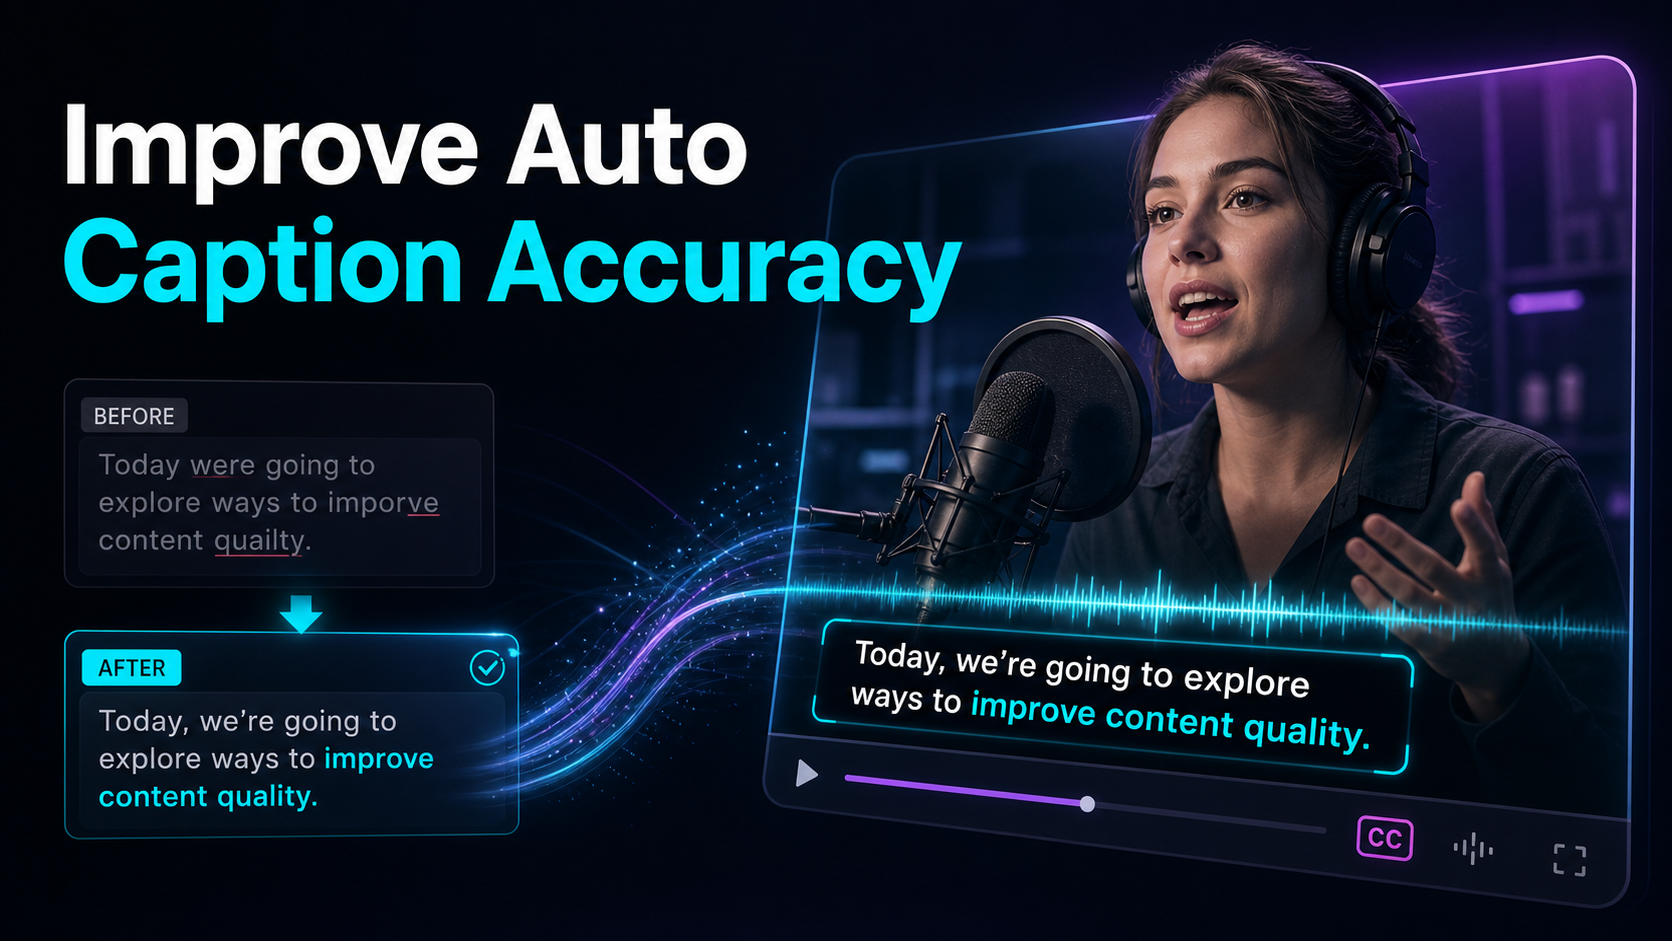
Les sous-titres automatiques se trompent de noms, ponctuent au hasard et entendent mal des phrases entières — et les plus grands progrès pour améliorer la précision des sous-titres automatiques viennent moins du changement d’outil que de la correction de ce que vous donnez à l’outil. La reconnaissance vocale n’est aussi bonne que par l’audio qu’elle entend et les mots attendus, donc ce guide reste strict sur les leviers qu’un créateur contrôle réellement : un son d’entrée plus propre, des habitudes d’enregistrement qu’un transcripteur peut suivre, une liste de mots personnalisée pour les noms et le jargon, et une boucle rapide de transcription-édition-export qui capture tout ce qui passe à travers. Ces quatre légendes inexactes deviennent-elles une relecture rapide, pas un casse-tête récurrent ?
Pourquoi les sous-titres automatiques deviennent imprécis — et comment améliorer la précision des sous-titres automatiques
Avant de pouvoir corriger les sous-titres automatiques, il est utile de savoir pourquoi ils manquent. Chaque fonction de sous-titrage automatique fonctionne par reconnaissance vocale : le modèle écoute votre audio, devine les mots les plus probables et marque les timings dessus. Il échoue de manière prévisible — et la plupart de ces échecs remontent à l’entrée, pas à l’algorithme.
| Causes des erreurs Sous ton contrôle ? La solution |
| Musique de fond ou bruit sous la parole | Oui | Nettoie l’audio avant de transcrire |
| Deux personnes qui parlent en même temps | Oui | Isoler un haut-parleur par segment |
| Écho de la pièce / réverbération | Surtout | Enregistre plus près, soigne la pièce |
| Noms, marques, jargon, acronymes | Oui | Alimentez une liste de mots personnalisée, relisez-la |
| Livraison rapide, marmonnée ou brève | Oui | Ralentis, articule, micro ferme |
| Accent fort ou langue non native | En partie | Choisissez un transcripteur qui s’en occupe |
| Audio à faible débit binaire ou audio de haut-parleur téléphonique | Oui | Enregistrer dans un fichier source propre |
Lisez cette colonne de réponses « oui » et la stratégie s’écrit d’elle-même. On ne peut pas toujours changer un accent sur l’enregistrement de quelqu’un d’autre, mais on peut presque toujours donner au transcripteur l’audio du nettoyeur et une liste des mots qu’il risque de rater. C’est là le levier — et pourquoi courir après un outil « plus intelligent » avant de corriger l’entrée déçoit généralement.
Corrigez d’abord l’entrée : un son propre pour les sous-titres
Le nettoyage de l’audio source est une variable utile à tester car un transcripteur ne peut que sous-titrer clairement le signal qu’il reçoit. Deux problèmes dominent.
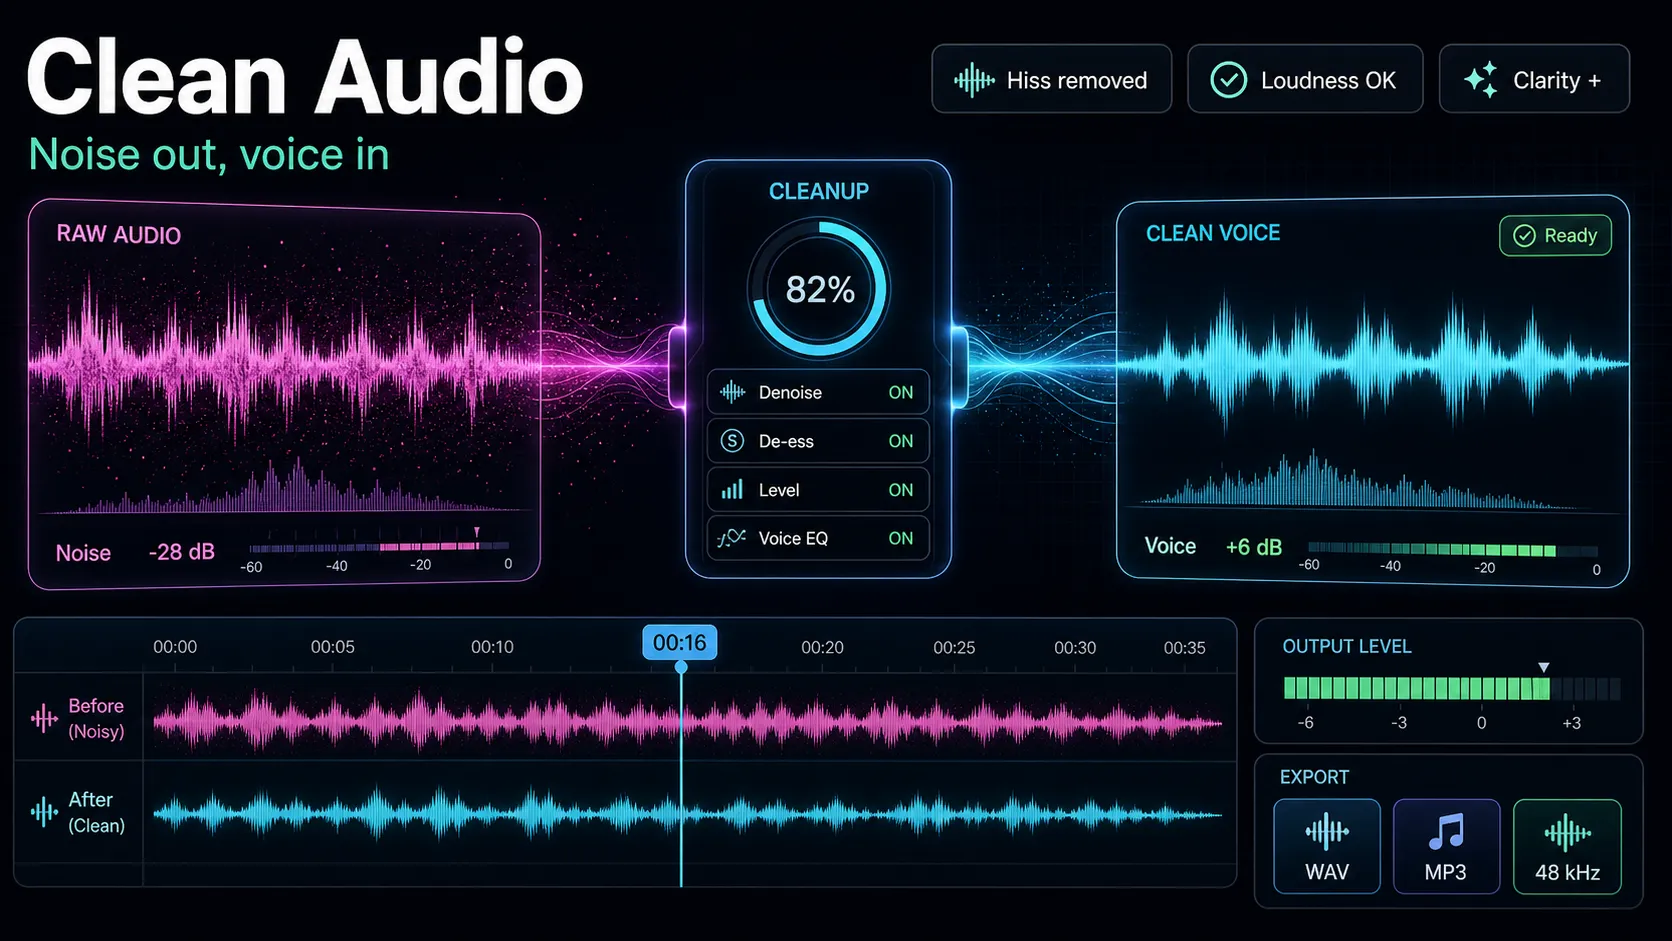
Bruit de fond constant — bourdonnement du CVC, trafic, ventilateurs d’ordinateur portable, sifflement de bande — sous-entend votre voix et brouille les contours des mots, pour que le modèle devine. Faire passer la piste dans audio-noise-reduction avant de transcrire fait descendre ce sol et transmet au modèle un signal plus propre. Faites cela sur l’audio source, pas après le sous-titrage — l’objectif est d’améliorer ce que le transcripteur entend, pas de patcher la sortie.
Un lit de musique sous la voix est le plus sournois. La musique partage l’espace fréquentiel avec la parole, donc un transcripteur essayant de sous-titrer une tête parlante sur une piste d’accompagnement va lâcher et mal entendre des mots qu’il aurait réussis sur une voix sèche. Si votre enregistrement contient des paroles et de la musique mélangées dans une seule piste, isole la voix avec stem-splitter], transcris à partir de la voix claire, puis reprends la musique pour le mix final. Tu sous-titres la voix, pas la chanson qui la combat.
L’ordre compte : d’abord nettoyer, transcrire ensuite — une voix sans bruit et sans musique apporte plus de précision que toute correction après coup. Si le nettoyage audio vous est nouveau, notre guide guide sur comment nettoyer l’audio pour la vidéo couvre l’ordre complet des opérations.
Enregistrer pour que le transcripteur puisse suivre
La moitié de la précision est décidée avant même d’appuyer sur « générer », au moment de l’enregistrement. Un transcripteur n’est pas un lecteur de pensées — il suit le signal le plus clair qu’il lui donne, et ces habitudes ne coûtent rien.
- Micro proche, micro cohérent. Une source proche du haut-parleur et à un niveau stable donne au modèle des consonnes nettes — là où la plupart des erreurs de mots se cachent — au lieu d’un lavage lointain couleur pièce.
- Un haut-parleur à la fois. Le diaphonie est l’endroit où les sous-titres automatiques tombent le plus vite. Quand deux voix se chevauchent, le modèle ne peut pas attribuer clairement l’un ou l’autre, donc il brouille les deux. Lors des interviews, les invités en coach laissent un rythme s’installer avant de répondre.
- Apprivoiser la pièce. La réverbération étale les fins des mots. Enregistrer dans un espace meublé et doux, ou plus près du micro dans un espace lumineux, coupe l’écho que le modèle doit traverser.
- Articulez à un rythme humain. Vous n’avez pas besoin de diction radio — il suffit d’éviter la voix marmonnée, sèche ou précipitée que même quelqu’un vous demanderait de répéter. Si un mot est important (un nom, un chiffre), pose-le proprement.
Construis une liste de mots personnalisée pour les noms et le jargon
Voici la solution que la plupart des créateurs ignorent, et c’est celle qui élimine les erreurs qui vous embarrassent le plus. La reconnaissance vocale est biaisée en faveur des mots courants. Donnez-lui un mot « Recapo », le nom de famille d’un client, un SKU de produit ou un acronyme de niche, et il atteindra le mot le plus proche du quotidien — c’est pourquoi les noms propres et le jargon sont là où les sous-titres inexacts se regroupent.
La correction prend deux formes :
- Un dictionnaire personnalisé, si votre outil en prend en charge. Certains transcripteurs permettent d’enregistrer des termes — noms, marques, vocabulaire technique — avant d’exécuter le travail, afin que le modèle les attende. Quand cette option existe, c’est la manière la plus propre de bien choisir les noms du premier coup. Chargez constamment les mots que votre chaîne dit : votre propre marque, des invités récurrents, le jargon de votre niche.
- Une liste de corrections réutilisable, si ce n’est pas le cas. Pas de champ de dictionnaire personnalisé ? Gardez un court fichier texte des termes que votre transcripteur déforme toujours et de la façon dont ils doivent être interprétés. Corrigez-les une fois par vidéo pendant la relecture, et comme vous collez à partir d’une liste connue, le passage prend quelques secondes au lieu d’une chasse.
Dans tous les cas, le principe est le suivant : le transcripteur peut parfaitement maîtriser un discours ordinaire par lui-même ; Votre travail est de lui donner la poignée de mots rares qu’il ne peut deviner. Cette seule habitude transforme la plupart des plaintes du type « pourquoi il continue d’écrire mon nom » en un problème résolu.
Choisissez un transcripteur qui correspond à votre audio
Tous les moteurs de reconnaissance vocale ne gèrent pas tous les types d’audio de manière égale — accents, voix qui se chevauchent, vocabulaire technique et langues non anglaises distinguent tous ces outils. Mais ne faites pas confiance à un pourcentage de « précision » marketing ; Elle a été mesurée sur un son studio propre qui ne ressemble en rien au vôtre. Fais plutôt ton propre test.
Prenez vos pires 60 secondes — l’invité avec accent, le lieu bruyant, le segment chargé de jargon — et passez-les dans n’importe quel transcripteur que vous pesez. Ensuite, évaluez la sortie selon ce qui compte réellement :
- Noms propres. A-t-il bien reçu les noms, les marques et les lieux, ou inventé les homophones ?
- Ponctuation et casuscule. Les phrases sont-elles brisées de manière sensée, ou s’agit-il d’un bloc interminable ?
- Modifiable. Pouvez-vous corriger la transcription en place, idéalement à côté de la vidéo, plutôt que d’exporter et de réimporter ?
- Synchronisation au niveau des mots. Est-ce que cela marque les timings par mot, pas seulement par ligne — les données dont vous avez besoin pour des légendes précises et bien synchronisées ?
- Langues que vous utilisez réellement. Si vous sous-titragez dans plusieurs langues, est-ce que cela tient la route pour chacune ?
Un outil qui transmet votre véritable audio vous servira ; Un qui ne brille que sur un clip de démo ne le fera pas. Un générateur de sous-titres ai](/fr/tools/ai-subtitle-generator/) à usage général qui produit une transcription modifiable et synchronisée avec un mot vous laisse le plus de marge pour corriger ce qui reste. Pour un aperçu plus large des options, consultez notre synthèse des meilleurs générateurs d’auto-sous-titres ](/fr/blog/best-auto-caption-generators/).
La boucle de relecture : où les dernières erreurs meurent
Même avec un son propre et une bonne liste de mots, aucun passage automatique n’est prêt à publier sans être modifié — et les sous-titres courts sont gravés dans la vidéo, rendant une faute de frappe permanente. Une boucle de relecture serrée se situe entre « en grande partie juste » et « vraiment juste ».
- Générez la transcription. Faites passer votre audio nettoyé dans auto-captions pour obtenir des sous-titres chronométrés avec une chronologie par mot — vous corrigerez le brouillon éditable, pas le mot final.
- Scannez d’abord les jetons à haut risque. Vous ne relisez pas chaque mot ; Vous cherchez les quatre choses que les transcripteurs manquent le plus : noms, homophones (« leur/là », « à/deux »), chiffres (prix, dates, statistiques) et jargon. Corrigez cela et vous aurez détecté les erreurs qui vous ont réellement coûté crédibilité.
- Édition à côté de la vidéo. Correct dans une vue transcription qui lance l’extrait à côté du texte, pour corriger les erreurs dans le contexte et confirmer que le timing n’a pas dévié. C’est bien plus rapide que de modifier un fichier de sous-titres brut à l’aveugle.
- Lisez-la une fois, coupée. Faites écouter la vidéo en sourdine et ne lisez que les légendes, comme le ferait un spectateur sans son — certains spectateurs rencontrent des vidéos courtes avec le son coupé, selon les recommandations d’accessibilité des plateformes. Tout ce qui se lit mal est corrigé silencieusement maintenant.
- Gravez et exportez. Ce n’est qu’une fois la transcription nette que vous rendez les sous-titres dans les images. Comme le burn-in est permanent, la relecture n’est jamais l’étape que vous sautez.
Cette boucle est courte par conception : plus votre entrée et votre liste de mots sont propres, moins il y a de corriger ici.
Conseils pour la précision des sous-titres en un coup d’œil
Gardez cette liste à côté de votre flux de travail — c’est le chemin le plus court pour améliorer les sous-titres automatiques. La plupart des problèmes de précision meurent si tu le descends avant d’atteindre générer.
- Nettoyez d’abord l’audio : réduisez le bruit, puis séparez les couches musicales pour transcrire une voix sèche.
- Enregistrer de près, de niveau et une voix à la fois : peu de diaphonie et de réverbération minimales.
- Nourrissez une liste de mots personnalisée : marque, noms, jargon, acronymes — et testez l’outil sur votre pire clip, pas sur une démo propre.
- Relisez les jetons à haut risque : noms, homophones, chiffres, jargon — et lisez-les en sourdine avant de brûler, car les erreurs gravées sont permanentes.
Où Recapo s’intègre
Recapo’est un espace de travail vidéo IA basé sur navigateur — rien à installer — et toute la boucle de précision de ce guide s’y déroule de bout en bout. Vous pouvez réduire le bruit de fond, séparer un lit musical de la voix, transcrire et sous-titrer en une transcription au niveau des mots et modifiable, relire les noms et numéros à côté de la vidéo, puis redimensionner à 9:16 et exporter avec les sous-titres gravés — le tout dans un seul onglet, sans passer un fichier entre un dénoise de lecture, un transcripteur et un éditeur. Il accepte les formats MP4, MOV et autres courants, jusqu’à 6 Go au total par tâche.
Le choix pratique : Recapo nettoie l’entrée et vous donne une transcription modifiable, mais il ne peut pas inventer un nom qu’il n’a jamais entendu ni décider de quel homophone vous parlez. Ces jugements — la liste personnalisée de mots, la lecture atténuée, la relecture finale — restent à vous, et c’est ce qui transforme un bon passage automatique en un passage propre. Si le sous-titrage fait partie de votre routine, avoir un audio propre, une transcription et une relecture dans un seul onglet est le travail pour lequel il est conçu. Les plans sont disponibles sur la page des prix.
FAQ
Pourquoi mes sous-titres automatiques sont-ils si inexacts ?
Presque toujours à cause de l’audio, pas de l’outil. Le bruit de fond, un fond musical sous la voix, des haut-parleurs qui se chevauchent, et des paroles marmonnées ou lointaines forcent tous le modèle vocal à deviner, et il se trompe sur les mots difficiles. Les noms, les marques et le jargon ajoutent une seconde couche, car la reconnaissance est biaisée en faveur des mots courants. Nettoyez l’audio, enregistrez de façon plus proche avec une voix à la fois, et passez au transcripteur vos termes rares — cela corrige la plupart des sous-titres inexacts avant même que vous ne relisiez.
Le nettoyage de l’audio améliore-t-il vraiment la précision des sous-titres ?
Oui, et c’est généralement la plus grande victoire individuelle. Un transcripteur ne peut que sous-titrer ce qu’il entend clairement, donc un bruit constant et une piste musicale concurrente provoquent directement des mots tombés et des erreurs. Réduire le bruit de la source et isoler la voix de tout couche musicale avant de transcrire donne au modèle un signal plus propre et élimine les erreurs à la racine — bien plus efficacement que de corriger la sortie par la suite.
Comment corriger les noms et le jargon dans les sous-titres automatiques ?
Deux façons. Si votre transcripteur supporte un dictionnaire personnalisé, enregistrez les noms, marques et termes techniques avant d’exécuter le travail afin que le modèle s’y attende. Si ce n’est pas le cas, gardez une courte liste réutilisable des mots qu’il déforme toujours et collez les corrections pendant la relecture. Toute approche transforme les erreurs qui vous embarrassent le plus — votre propre marque ou le nom d’un invité mal orthographié — en une correction résolue et répétable.
Puis-je améliorer la précision sans réenregistrer ?
Souvent, oui. Vous pouvez réduire le bruit de la piste existante, séparer un lit musical de la voix, et passer l’audio nettoyé dans un transcripteur qui gère votre type de discours, puis relire le résultat — tout cela sans rien enregistrer à nouveau. Le réenregistrement ne paie que lorsque la source elle-même pose problème (diaphonie intense, réverbération sévère ou capture d’enceintes téléphoniques) ; Pour la plupart des séquences, nettoyer l’entrée et relire comble le fossé.
Quelle précision dois-je attendre des sous-titres automatiques ?
Cela varie trop pour en promettre un — un audio clair, micro proche et mono-haut-parleur, transcrit bien mieux qu’un enregistrement multi-haut-parleurs bruyant, et les résultats varient selon la langue et l’accent. Plutôt que de faire confiance au pourcentage de titres d’un fournisseur, testez n’importe quel outil sur vos 60 pires secondes. Quel que soit l’outil, prévoyez une courte relecture des noms, homophones et numéros avant de graver les légendes — cette dernière lecture est ce qui les rend prêts à la publication.
Prêt à arrêter de lutter contre des sous-titres inexacts ? Créez un compte gratuit, téléchargez vos séquences — MP4 ou MOV, jusqu’à 6 Go au total par tâche — et exécutez toute la boucle de précision dans un seul onglet de navigateur : supprimer le bruit, séparer n’importe quel lecteur musical, transcrire en une transcription éditable au niveau du mot que vous avez relue à côté de la vidéo, puis recadrer à 9:16 et exporter avec les légendes gravées. Vous apportez l’audio clair et la lecture finale ; Recapo gère la production, donc votre prochaine publication est livrée avec des légendes indiquant ce que vous avez réellement dit.
Références et sources officielles
- Aide YouTube : Ajouter des sous-titres et légendes
- Documents Web MDN : WebVTT API
- Recapo.ai : Aperçu du produit et limites actuelles de téléchargement
- Recapo.ai : Éditeur vidéo IA
- FFmpeg : Documentation officielle