Wie man die Genauigkeit der automatischen Unterschriften verbessert (weniger Fehler)
Wie man die Genauigkeit der automatischen Untertitel verbessert: Reinigen Sie den Eingabeton, nehmen Sie auf, damit Transkribierende folgen können, geben Sie eine benutzerdefinierte Wortliste für Namen ein.
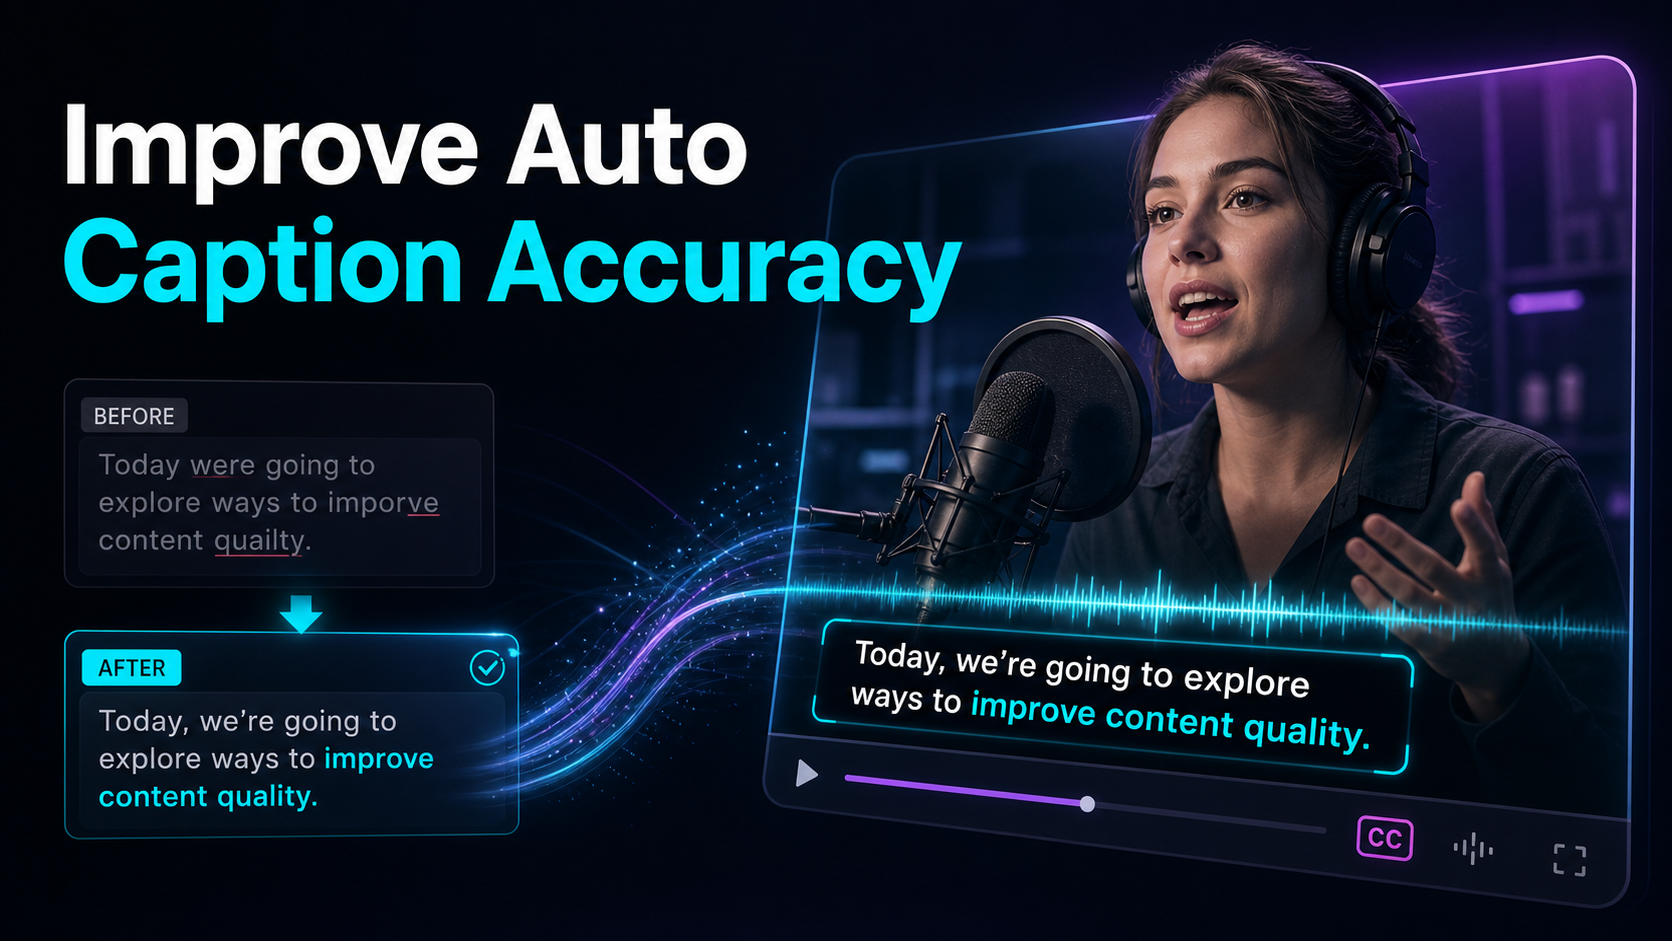
Auto-Untertitel haben Namen falsch, setzen zufällig Zeichenzeichen und verstehen ganze Phrasen falsch – und die größten Erfolge bei der Verbesserung der Genauigkeit der Auto-Unterschriften entstehen weniger durch das Wechseln von Werkzeugen, sondern vielmehr durch das Beheben dessen, was man dem Tool einführt. Sprache-zu-Text ist nur so gut wie der Klang, den er hört, und die erwarteten Worte, daher bleibt dieser Leitfaden eng bei den Hebeln, die ein Schöpfer tatsächlich steuert: sauberere Eingabe-Audio, Aufzeichnungsgewohnheiten, denen ein Transkribierender folgen kann, eine benutzerdefinierte Wortliste für Namen und Fachjargon sowie eine schnelle Transkribieren-Editier-Exportschleife, die alles auffängt, was durchrutscht. Machen diese vier und ungenaue Bildunterschriften schnell zum Korrekturlesen, nicht zu einem wiederkehrenden Kopfschmerz.
Warum automatische Untertitel ungenau werden – und wie man die Genauigkeit von automatischen Untertiteln verbessert
Bevor du automatische Untertitel reparieren kannst, hilft es zu wissen, warum sie verfehlen. Jede automatische Untertitelfunktion läuft über Spracherkennung: Das Modell hört deinen Audio, errät die wahrscheinlichsten Wörter und stempelt Zeitangaben darauf. Sie scheitert auf vorhersehbare Weise – und die meisten dieser Fehler liegen auf die Eingabe, nicht auf den Algorithmus.
| Ursache der Fehler Unter deiner Kontrolle? Die Lösung |
| Hintergrundmusik oder Geräusche in der Sprache | Ja | Bereinige das Audio vor dem Transkribieren |
| Zwei Menschen, die durcheinander reden | Ja | Isoliere pro Segment einen Lautsprecher |
| Raumecho / Hall | Meistens | Nimm näher auf, behandle den Raum |
| Namen, Marken, Fachjargon, Akronyme | Ja | Führe eine benutzerdefinierte Wortliste ein, Korrektur lesen |
| Schnelle, gemurmelte oder abgehackte Darbietung | Ja | Langsamer, deutlich sprechen, Mikrofon schließen |
| Starker Akzent oder nicht-muttersprachliche Sprache | Teilweise | Wähle einen Transkribierenden, der das übernimmt |
| Audio mit niedriger Bitrate oder Telefonlautsprecher | Ja | Speichern Sie auf eine saubere Quelldatei |
Lies diese Spalte mit "Ja"-Antworten und die Strategie schreibt sich von selbst. Man kann nicht immer einen Akzent auf einer fremden Aufnahme ändern, aber man kann dem Transkribierenden fast immer saubereres Audio und eine Liste der Wörter geben, die er wahrscheinlich verpatzt. Das ist die Hebelwirkung – und deshalb enttäuscht es meist, einem "intelligenteren" Tool hinterherzujagen, bevor man die Eingabe bearbeitet.
Zuerst die Eingabe korrigieren: Sauberer Ton für Untertitel
Das Reinigen des Quelltons ist eine nützliche Variable zum Testen, da ein Transkribierender das empfangene Signal nur klar untertiteln kann. Zwei Probleme dominieren.
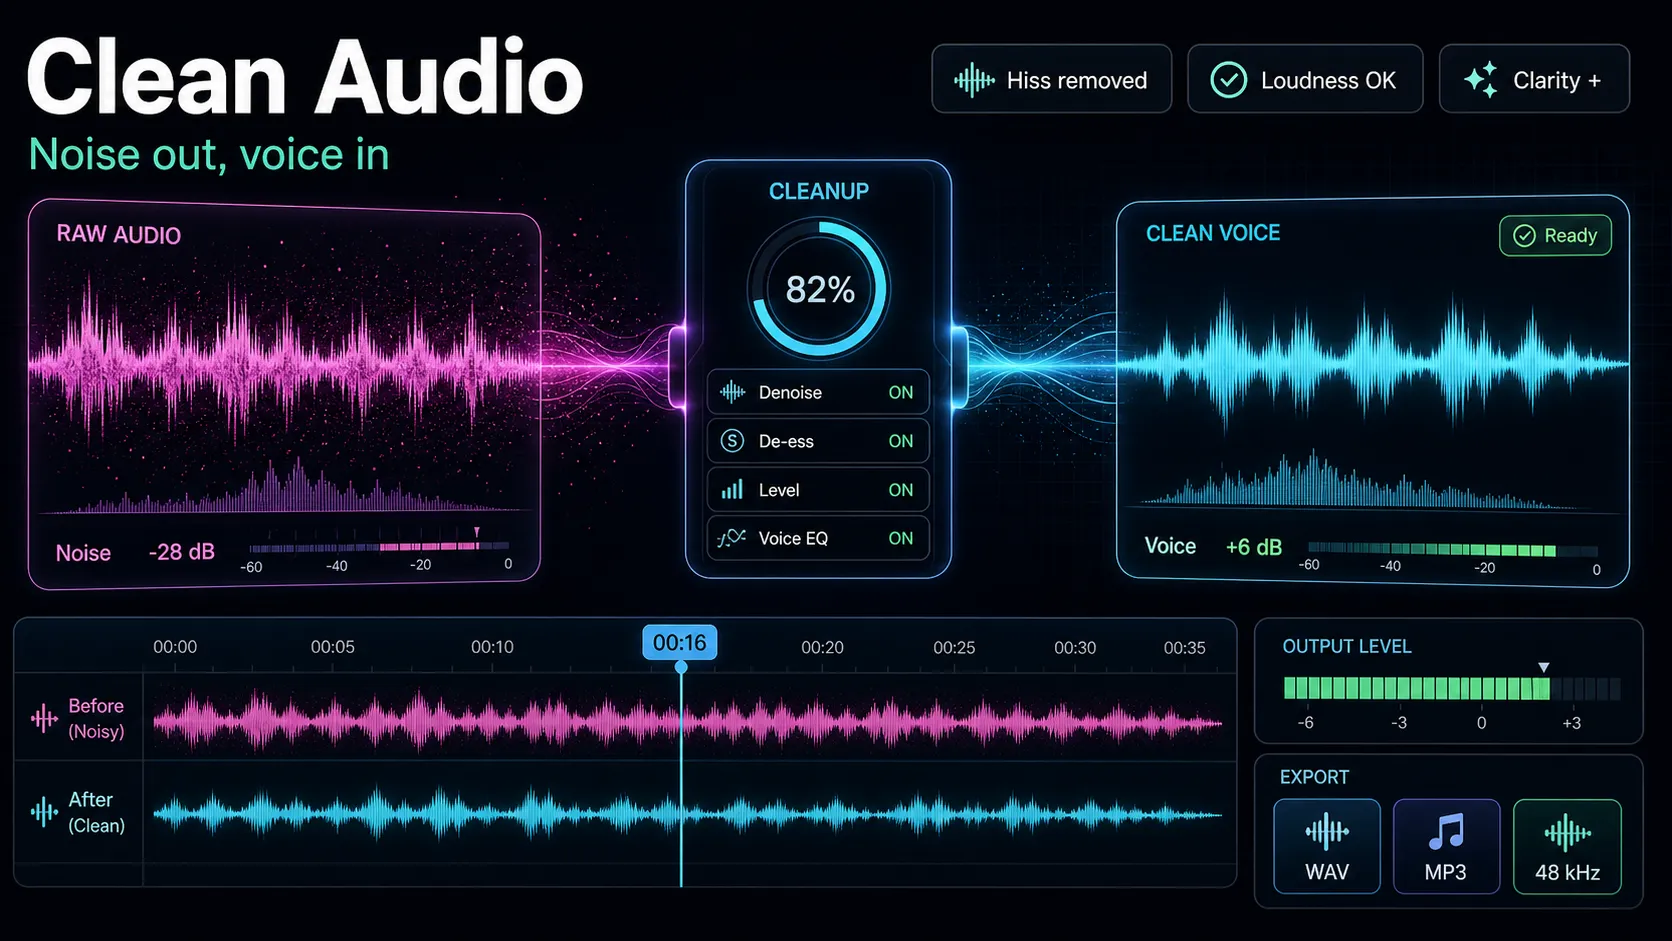
Stetiges Hintergrundrauschen – HLK-Brummen, Verkehr, Laptop-Lüfter, Klebebandrauschen – liegt unter deiner Stimme und verwischt die Ränder der Worte, sodass das Modell raten kann. Wenn man die Spur vor der Transkribierung durch audio-noise-reduction] durchführt, wird die Bodenschicht nach unten gezogen und das Modell erhält ein saubereres Signal. Mach dies auf dem Quellaudio, nicht nach dem Untertiteln – das Ziel ist es, das zu verbessern, was der Transkribierende hört, nicht die Ausgabe zu patchen.
Ein Musikbett unter der Stimme ist das heimschlecherste. Musik teilt sich den Frequenzraum mit der Sprache, sodass ein Transkribierter, der versucht, einen Sprecher über eine Backing-Track zu untertiteln, Wörter versteht und die er auf einem trockenen Gesang verwechselt hätte. Wenn deine Aufnahme Sprache und Musik in einer Spur mischt, isoliere die Stimme mit stem-splitter, transkribiere vom cleanen Gesang und bringe die Musik dann für den finalen Mix zurück. Du unterschreibst die Stimme, nicht das Lied, das dagegen kämpft.
Die Reihenfolge zählt: zuerst sauber, dann transkribieren – ein entrauschter, musikfreier Gesang trägt mehr zur Genauigkeit als eine nachträgliche Korrektur. Falls die Audioreinigung neu für Sie ist, behandelt unser Walkthrough wie man Audio für Video aufreinigt] die vollständige Reihenfolge der Operationen.
Zeichnen Sie auf, damit der Transkribierende folgen kann
Die Hälfte der Genauigkeit wird bestimmt, bevor man überhaupt auf "Generieren" klickt, also im Moment der Aufnahme. Ein Transkribierender ist kein Gedankenleser – er folgt dem klarsten Signal, das ihm gegeben wird, und diese Gewohnheiten kosten nichts.
- Mikrofon zu, Mikrofon konsistent. Eine Quelle in der Nähe des Lautsprechers und auf gleichmäßigem Pegel liefert dem Modell klare Konsonanten – wo sich die meisten Wortfehler verstecken – statt einer fernen, raumfarbigen Schicht.
- Ein Sprecher nach dem anderen. Crosstalk ist der Ort, an dem automatische Untertitel am schnellsten auseinanderfallen. Wenn sich zwei Stimmen überlappen, kann das Modell keine der beiden klar zuordnen, sodass beide verzerrt werden. In Interviews coachen Sie die Gäste, einen Beat landen zu lassen, bevor Sie antworten.
- Zähme den Raum. Hall verschmiert Wortendungen. Die Aufnahme in einem weich eingerichteten Raum oder näher am Mikrofon in einem hellen Raum schneidet das Echo ab, das das Modell durchstehen muss.
- Artikuliere im menschlichen Tempo. Du brauchst keine Funkdiktion – vermeide einfach das gemurmelte, abgehackte oder überhastete Sprechen, das selbst ein Mensch von dir bitten würde, zu wiederholen. Wenn ein Wort wichtig ist (ein Name, eine Zahl), lande es sauber.
Erstellen Sie eine benutzerdefinierte Wortliste für Namen und Fachjargon
Hier ist die Lösung, die die meisten Ersteller überspringen, und sie ist diejenige, die die Fehler beseitigt, die dich am meisten blamieren. Spracherkennung ist zugunsten gewöhnlicher Wörter voreingenommen. Geben Sie ihm "Recapo", den Nachnamen eines Kunden, eine Produkt-SKU oder ein Nischen-Akronym ein, greift es stattdessen zum nächstgelegenen Alltagswort – weshalb Eigennamen und Fachjargon die Punktzahl sind, an der sich ungenaue Bildunterschriften häufen.
Die Korrektur hat zwei Formen:
- Ein benutzerdefiniertes Wörterbuch, falls Ihr Tool eines unterstützt. Einige Transkribierende erlauben es Ihnen, Begriffe – Namen, Marken, technisches Vokabular – vor der Ausführung der Arbeit zu registrieren, sodass das Modell sie erwartet. Wenn es diese Option gibt, ist es der sauberste Weg, Namen gleich beim ersten Mal richtig zu machen. Lade ständig die Worte, die dein Kanal sagt: deine eigene Marke, wiederkehrende Gäste, den Fachjargon deiner Nische.
- Eine wiederverwendbare Korrekturliste, falls nicht. Kein benutzerdefiniertes Wörterbuchfeld? Führen Sie eine kurze Textmappe mit den Begriffen, die Ihr Transkribierender immer verdreht und wie sie gelesen werden sollten. Beheben Sie sie einmal pro Video beim Korrekturlesen, und da Sie von einer bekannten Liste einfügen, dauert der Durchgang Sekunden statt einer Suche.
So oder so gilt das Prinzip: Der Transkribierende kann gewöhnliche Sprache eigenständig meistern; Deine Aufgabe ist es, ihm die wenigen ungewöhnlichen Wörter zu geben, die er nicht erraten kann. Diese eine Gewohnheit macht die meisten Beschwerden von "Warum schreibt mein Name immer falsch?" zu einem gelösten Problem.
Wähle einen Transskriptierer, der zu deinem Audio passt
Nicht jede Sprach-zu-Text-Engine behandelt jede Art von Audio gleich – Akzente, sich überlappende Sprache, technischer Wortschatz und nicht-englische Sprachen trennen die Werkzeuge. Aber vertraue nicht auf einen Marketing-"Genauigkeits"-Prozentsatz; Es wurde auf sauberem Studio-Audio gemessen, das ganz anders aussieht als deins. Führe stattdessen deinen eigenen Test durch.
Nimm deine schlechtesten 60 Sekunden – den akzentuierten Gast, den lauten Ort, das jargonlastige Segment – und lass sie durch jeden Transkribierenden laufen, den du abwägst. Dann bewerten Sie die Ergebnisse nach dem, was wirklich zählt:
- Eigennamen. Hat es Namen, Marken und Orte richtig verstanden oder Homophone erfunden?
- Interpunktion und Verkleidung. Werden Sätze sinnvoll gebrochen, oder ist es nur ein einziger Block?
- Bearbeitungsfähigkeit. Kannst du das Transkript korrigieren, idealerweise neben dem Video, anstatt es zu exportieren und erneut zu importieren?
- Wort-Level-Timing. Stempelt es Timings pro Wort, nicht nur pro Zeile – die Daten, die man für präzise, gut synchronisierte Untertitel benötigt?
- Sprachen, die du tatsächlich benutzt. Wenn du in mehr als einer Sprache untertitelst, hält das in jeder Sprache?
Ein Tool, das dein echtes Audio weitergibt, wird dir dienen; Einer, der nur auf einem Demo-Clip glänzt, tut das nicht. Ein allgemeiner ai-subtitle-generator], der ein editierbares, wortgesteuertes Transkript erstellt, gibt dir am meisten Spielraum, um das Verbliebene zu korrigieren. Für eine umfassendere Auswahl der Optionen siehe unsere Zusammenfassung der besten Auto-Caption Generators].
Die Korrekturschleife: Wo die letzten Fehler sterben
Selbst mit sauberem Audio und einer guten Wortliste bleibt kein automatischer Untertitel-Pass veröffentlichungsbereit und unberührt – und Kurzuntertitel werden ins Video eingebrannt, sodass ein Tippfehler dauerhaft wird. Eine enge Korrekturschleife ist das, was zwischen "größtenteils richtig" und "eigentlich richtig" steht.
- Erstelle das Transkript. Führe dein gereinigtes Audio durch auto-captions, um zeitlich begrenzte Untertitel mit einer Wort-Timeline zu erhalten – den editierbaren Entwurf, den du korrigierst, nicht das Endwort.
- Scanne zuerst die Hochrisiko-Token. Du liest nicht jedes Wort nochmal; Man sucht nach den vier Dingen, die Transkribierende am meisten vermissen: Namen, Homophone ("Ihr/Dor", "To/Two"), Zahlen (Preise, Daten, Statistiken) und Fachjargon. Beheben Sie diese und Sie haben die Fehler entdeckt, die Ihre Glaubwürdigkeit tatsächlich gekostet haben.
- Edit neben dem Video. Korrigiere in einer Transkriptansicht, die den Clip neben dem Text abspielt, damit du Fehlhörungen im Kontext korrigierst und sicherst, dass das Timing nicht abgedriftet ist. Das ist viel schneller als das blinde Bearbeiten einer rohen Untertiteldatei.
- Einmal lesen, stummgeschaltet. Spielen Sie das Video stumm ab und lesen Sie nur die Untertitel, so wie es ein Zuschauer ohne Ton tun würde – manche Zuschauer begegnen kurzformatigen Videos mit ausgeschaltetem Ton, laut den eigenen Barrierefreiheitsrichtlinien der Plattformen. Alles, was falsch liest, wird jetzt still und leise behoben.
- Einbrennen und exportieren. Erst nachdem das Transkript sauber ist, rendern Sie die Bildunterschriften in die Rahmen. Da Burn-in dauerhaft ist, überspringt man nie das Korrekturlesen.
Diese Schleife ist von Natur aus kurz: Je sauberer deine Eingabe und Wortliste, desto weniger gibt es hier zu korrigieren.
Tipps zur Genauigkeit der Bildunterschriften auf einen Blick
Behalten Sie diese Checkliste neben Ihrem Arbeitsablauf – es ist der kürzeste Weg zu besseren automatischen Untertiteln. Die meisten Genauigkeitsprobleme sterben, wenn du sie herunterläufst, bevor du auf Generieren klickst.
- Reinige zuerst den Ton: Entrauschen und das Musikbett aufteilen, damit du einen trockenen Gesang transkribierst.
- Nah, gleichmäßig und eine Stimme aufnehmen: minimales Übersprechen und Hall.
- Füttere eine benutzerdefinierte Wortliste: Marke, Namen, Fachjargon, Abkürzungen – und teste das Tool an deinem schlechtesten Clip, nicht an einer sauberen Demo.
- Korrekturlesen Sie die risikoreichen Tokens: Namen, Homophone, Zahlen, Fachjargon – und lesen Sie sie stumm, bevor Sie einbrennen, denn eingebrannte Fehler sind dauerhaft.
Wo Recapo hineinpasst
Recapo ist ein browserbasierter KI-Video-Arbeitsbereich – nichts zu installieren – und die gesamte Genauigkeitsschleife in diesem Leitfaden läuft von Anfang zu Ende darin. Man kann Hintergrundgeräusche reduzieren, ein Musikbett vom Gesang abspalten, auf Wortebene transkribieren, ein editierbares Transkript bearbeiten, Namen und Zahlen neben dem Video Korrektur lesen, dann auf 9:16 vergrößern und mit eingebrannten Untertiteln exportieren – alles in einem Tab, ohne eine Datei zwischen einem Denoiser, einem Transkriptor und einem Editor zu verschieben. Es akzeptiert MP4, MOV und andere gängige Formate, insgesamt bis zu 6 GB pro Aufgabe.
Die praktische Lösung: Recapo bereinigt die Eingabe und gibt dir ein editierbares Transkript, aber es kann keinen Namen erfinden, den es nie gehört hat, oder entscheiden, welches Homophon du meinst. Diese Urteilsentscheidungen – die benutzerdefinierte Wortliste, das stummgeschaltete Durchlesen, das letzte Korrekturlesen – bleiben deine, und sie verwandeln einen guten Auto-Caption-Pass in einen sauberen. Wenn Untertitel ein wiederkehrender Bestandteil deiner Routine ist, ist es der Job, für sauberen Audio, Transkribieren und Korrekturlesen in einem einzigen Tab gedacht. Die Pläne stehen auf der Preisseite.
FAQ
Warum sind meine automatischen Untertitel so ungenau?
Fast immer wegen des Audios, nicht wegen des Tools. Hintergrundrauschen, ein Musikbett unter der Stimme, sich überlappende Lautsprecher und gemurmelte oder entfernte Stimme zwingen das Sprachmodell zum Raten, und es errät die schwierigen Wörter falsch. Namen, Marken und Fachjargon fügen eine zweite Ebene hinzu, weil die Wiedererkennung zugunsten gängiger Begriffe voreingenommen ist. Reinigen Sie das Audio, nehmen Sie mit einer Stimme nach dem anderen auf und geben Sie dem Transkribierenden Ihre ungewöhnlichen Begriffe ein – das korrigiert die meisten ungenauen Untertitel, bevor Sie überhaupt Korrektur lesen.
Verbessert das Aufräumen des Audios wirklich die Bilduntertitelgenauigkeit?
Ja, und es ist meistens der größte einzelne Sieg. Ein Transkribierender kann nur das beschriften, was er klar hört, sodass stetiges Rauschen und eine konkurrierende Musikspur direkt zu Fehlwörtern und Fehlwörtern führen. Die Quelle zu denoisen und die Stimme vor dem Transkribieren von jedem Musikbett zu isolieren, liefert dem Modell ein saubereres Signal und beseitigt Fehler am Grundton – viel effektiver als die Korrektur des Ausgangs danach.
Wie korrigiere ich Namen und Fachjargon in automatischen Untertiteln?
Zwei Möglichkeiten. Wenn dein Transskriptor ein benutzerdefiniertes Wörterbuch unterstützt, registriere die Namen, Marken und Fachbegriffe, bevor du den Job ausführst, damit das Modell sie erwartet. Wenn nicht, führe eine kurze, wiederverwendbare Liste der Wörter, die immer vermasselt werden, und füge die Korrekturen beim Korrekturlesen ein. Beide Ansätze verwandeln die Fehler, die Sie am meisten beschämen – Ihre eigene Marke oder der falsch geschriebene Name eines Gastes — in eine gelöste, wiederholbare Lösung.
Kann ich die Genauigkeit verbessern, ohne erneut aufzunehmen?
Oft ja. Man kann die vorhandene Spur entrauschen, ein Musikbett vom Gesang abspalten und den gereinigten Ton durch einen Transkribator laufen lassen, der die eigene Art von Sprache verarbeitet, und dann das Ergebnis Korrekturlesen – und das alles, ohne noch einmal etwas aufzunehmen. Neuaufnahme zahlt sich nur dann aus, wenn die Quelle selbst das Problem ist (starkes Übersprechen, starker Hall oder eine Telefonlautsprecheraufnahme); Bei den meisten Aufnahmen schließt das Reinigen der Eingabe und das Korrekturlesen die Lücke.
Welche Genauigkeit sollte ich von automatischen Untertiteln erwarten?
Es variiert zu sehr, um eine Zahl zu versprechen – saubere, eng mikrofonierte Ein-Lautsprecher-Audioaufnahmen transkribiert viel besser als eine laute Mehrsprecher-Aufnahme, und die Ergebnisse unterscheiden sich je nach Sprache und Akzent. Anstatt dem Schlagzeilenprozentsatz eines Anbieters zu vertrauen, testen Sie jedes Tool auf Ihre eigenen schlechtesten 60 Sekunden. Welches Werkzeug auch immer ist, planen Sie vor dem Einbrennen der Bildunterschriften eine kurze Korrekturlesung von Namen, Homophonen und Zahlen – genau dieser letzte Durchgang macht sie veröffentlichungsbereit.
Bereit, gegen ungenaue Bildunterschriften zu kämpfen? Erstelle ein kostenloses Konto, lade dein Filmmaterial hoch – MP4 oder MOV, bis zu 6 GB pro Aufgabe insgesamt – und führe die gesamte Genauigkeitsschleife in einem Browser-Tab durch: Rauschen entschärfen, das Musikbett abspalten, in ein auf Wortebene editierbares Transkript transkribieren, das du neben dem Video Korrektur liest, dann auf 9:16 umrahmen und mit eingebrannten Untertiteln exportieren. Du bringst den sauberen Ton und die letzte Durchlesung; Recapo übernimmt die Produktion, daher wird dein nächster Upload mit Bildunterschriften geliefert, die sagen, was du tatsächlich gesagt hast.
Quellen und offizielle Quellen
- YouTube Hilfe: Untertitel und Untertitel hinzufügen
- MDN Web Docs: WebVTT API
- Recapo.ai: Produktübersicht und aktuelle Upload-Grenzen
- Recapo.ai: KI-Videoeditor
- FFmpeg: Offizielle Dokumentation